04 — Publicaciones / Explicación
Cuando la IA pule sus propios consejos,
solo mejora en las primeras rondas
Un agente de IA convirtió los resultados de la IA explicable en consejos para los agricultores, y especialistas en cultivos y jueces de IA calificaron cada versión
El aprendizaje automático puede mostrar qué determina el rendimiento del arroz, pero contar esos resultados con palabras útiles para los agricultores no es fácil. Pedimos a un modelo de lenguaje de gran tamaño (LLM) que hiciera análisis adicionales y reescribiera diez veces sus consejos para los agricultores. Cuando 12 especialistas en cultivos calificaron todas las versiones, la mejor fue la de la tercera ronda. Después la calidad bajó, y en la ronda 10 quedó por debajo del primer borrador. Dejar que una IA pula sus propios consejos solo funciona si alguien sabe cuándo parar.
Puntos clave
- Las reescrituras subieron la nota cerca de un tercio. Las mejores versiones llegaron en las rondas 3 y 4. Después la nota bajó, y para los expertos la ronda 10 fue peor que el primer borrador.
- Las primeras versiones eran vagas, y las últimas se volvieron largas y abstractas. La IA también habló cada vez más de costes, aunque los datos no tenían ninguna información económica.
- Los LLM puntuaron entre 1,4 y 2,3 puntos más alto que los expertos. Aun así, ordenaron las rondas de forma muy parecida. El peor evaluador fue la misma IA que había escrito los consejos.
Llevar el análisis de la IA al lenguaje del campo
Con el aprendizaje automático podemos buscar, en los registros de rendimiento, los factores que lo suben o lo bajan. Los métodos que muestran por qué una IA hizo su predicción, de una forma que las personas puedan seguir, se llaman IA explicable (XAI). Uno de los más usados, SHAP, dibuja un gráfico de cuánto empujó cada factor el rendimiento hacia arriba o hacia abajo.
Sin embargo, estos gráficos están pensados para investigadores. Un agricultor no puede leer uno y saber qué hacer mañana en su parcela. Si los resultados no se entienden, nadie confiará en las predicciones de la IA, y las herramientas quedarán sin usar.
Los modelos de lenguaje como ChatGPT pueden ayudar. Saben convertir explicaciones técnicas en lenguaje cotidiano. Además, cada vez se usan más como «agentes de IA», que planifican sus propios pasos, hacen análisis adicionales y revisan sus respuestas sobre la marcha.
Entonces, si un agente de IA pule una explicación una y otra vez, ¿los consejos mejoran sin fin? Sospechábamos que no. Una explicación demasiado corta deja fuera puntos importantes. Una demasiado larga los entierra. En algún punto intermedio debería haber un nivel de detalle óptimo.
En este estudio, un agente de IA reescribió sus consejos ronda tras ronda, y seguimos cómo cambiaba su calidad. Las versiones las calificaron tanto especialistas en cultivos como LLM.
Diez rondas de reescritura
Datos de 28 arrozales de Fukushima
Usamos datos de 28 arrozales de una misma explotación agrícola en Tomioka, en la prefectura de Fukushima, con unas 7,5 ha en total. Allí se cultivaron cuatro variedades de 2021 a 2023, lo que dio 66 registros de parcela y año.
El modelo usó 37 variables. Siete describían el suelo, como la materia orgánica y el nitrógeno. Diez describían el manejo, como la variedad, los días hasta el espigado, la siembra directa o el trasplante, y si el cultivo era ecológico. Las otras 20 describían el clima, con la temperatura, la lluvia y la radiación solar de cuatro etapas del cultivo. El rendimiento se estimó con IA a partir de imágenes de dron, un método que contamos en otra explicación.
Un bosque aleatorio, un método común de aprendizaje automático, predijo el rendimiento a partir de estas variables. Lo pusimos a prueba ocultando un registro cada vez y prediciéndolo, y el modelo alcanzó un coeficiente de determinación (R²) de 0,749 (un valor de 1 sería una predicción perfecta). Luego aplicamos SHAP al modelo y resumimos en un solo gráfico los 20 factores más influyentes. Ese gráfico fue el punto de partida del agente de IA.
Tres pasos que se repiten
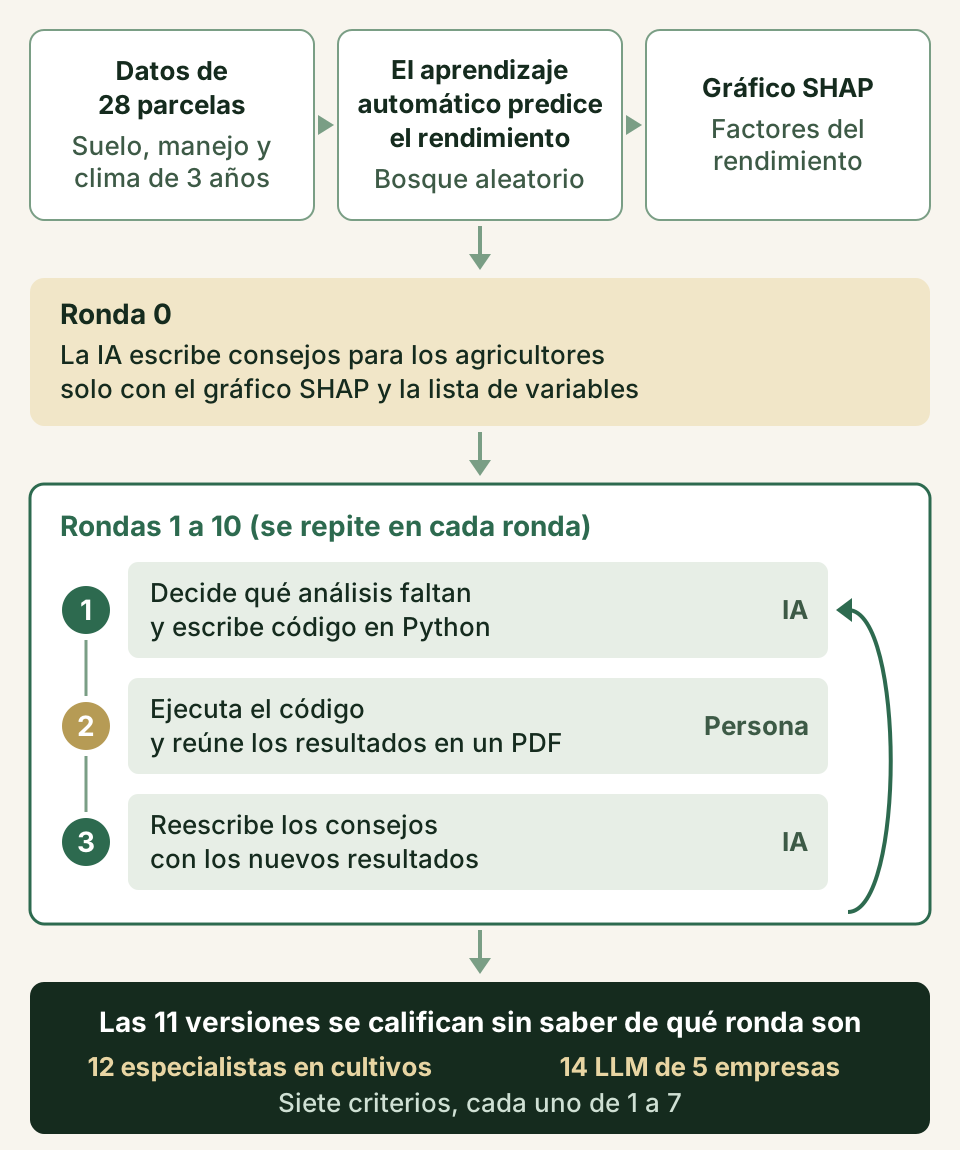
Los consejos los escribió Claude Sonnet 4, de Anthropic. En la ronda 0, la IA solo vio el gráfico SHAP y la lista de las 37 variables, y escribió consejos para los agricultores únicamente con eso (figura 1).
Las rondas 1 a 10 siguieron siempre los mismos tres pasos. Primero, la IA revisaba sus propios consejos, decidía qué comprobar y escribía el código en Python para el análisis. Después, una persona ejecutaba ese código con los datos de las parcelas y reunía las tablas y los gráficos en un PDF. Por último, la IA reescribía los consejos con ese PDF y el gráfico SHAP. Se conservó toda la conversación, así que cada ronda podía apoyarse en todos los resultados anteriores.
Una calificación a ciegas, por expertos y por IA
Dos grupos calificaron las 11 versiones. El primero lo formaban 12 especialistas en cultivos, todos con doctorado y miembros actuales o antiguos de la Sociedad Japonesa de Ciencias de los Cultivos. El segundo lo formaban 14 LLM de cinco empresas, OpenAI, Anthropic, xAI, DeepSeek y Google. Que un LLM califique textos se conoce como «LLM como juez». Es más rápido y barato que recurrir a personas, así que permite evaluar muchos más casos.
Los consejos se calificaron según siete criterios.
- La especificidad mide si los consejos dan cifras, métodos o pasos que el agricultor pueda usar directamente.
- La claridad mide si se entienden con facilidad y siguen un razonamiento claro.
- La concisión mide si un agricultor ocupado podría leerlos rápido durante un descanso.
- La viabilidad práctica mide si se pueden aplicar con la mano de obra, los conocimientos y el tiempo de una explotación típica.
- La pertinencia al contexto mide si se ajustan a la región, las variedades, el tamaño de las parcelas y el manejo que recogen los datos.
- La atención a los costes mide si tienen en cuenta los gastos y la rentabilidad de la inversión.
- La credibilidad agronómica mide si son sólidos desde la ciencia de los cultivos.
Cada criterio se calificó de 1 (muy malo) a 7 (excelente). Cada evaluador vio las versiones en un orden aleatorio distinto, y nadie supo de qué ronda era cada una. Cada LLM calificó en una conversación nueva, sin un historial previo que pudiera influirle.
Mejora solo hasta las rondas 3 y 4
Un máximo en las rondas 3 y 4, y después un descenso
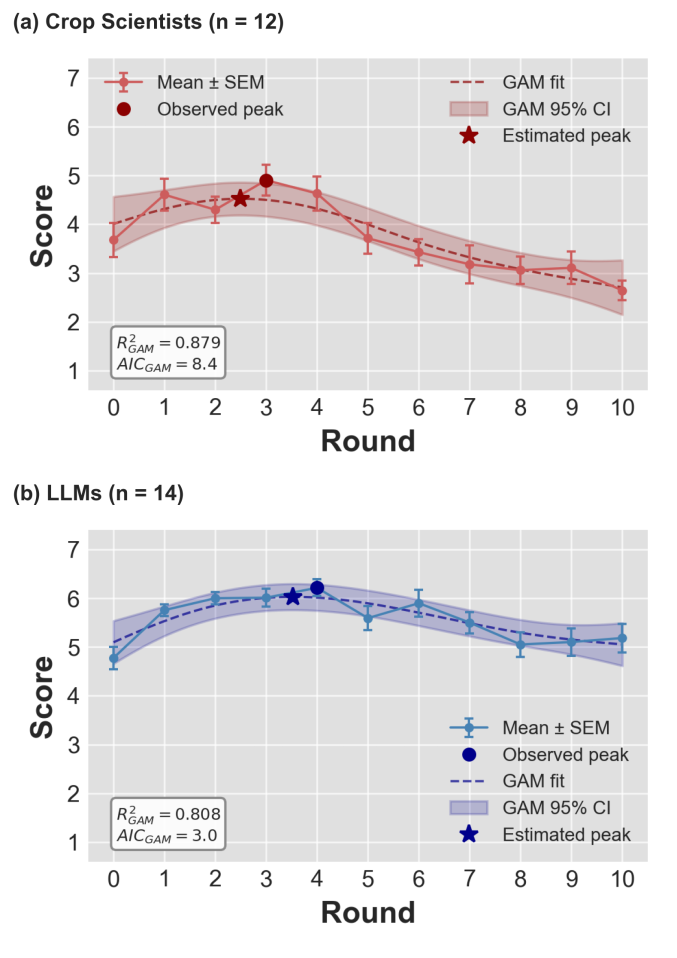
En los dos grupos, la media de los siete criterios subió y luego bajó (figura 2). La media de los especialistas pasó de 3,68 en la ronda 0 a 4,91 en la ronda 3, y cayó a 2,64 en la ronda 10. La ronda 10 obtuvo menos nota que el primer borrador sin revisar.
La media de los LLM subió de 4,78 en la ronda 0 a 6,21 en la ronda 4 y terminó en 5,18 en la ronda 10. En ambos grupos, la mejora en el máximo fue de cerca de un tercio (entre el 30 y el 33 %).
Las palabras vagas se volvieron cifras
Los propios consejos muestran por qué subió la nota. La figura 3 compara la ronda 0 y la ronda 3 en un mismo tema, el manejo de la temperatura al inicio de la campaña.
La ronda 0 ya señalaba los puntos en los que había que actuar, como la elección de la variedad y la profundidad del agua. Pero los dejaba en el aire, con palabras como «adecuado» y «poco profunda». En la ronda 3, los mismos puntos se habían convertido en umbrales que el agricultor podía comprobar, como los primeros 40 días tras el trasplante, una lámina de agua de 3 a 5 cm o máximas por debajo de 22 °C durante más de 5 días seguidos. Cada uno venía con una acción concreta. En las notas de los expertos, la especificidad fue el criterio que más subió (2,17 puntos).
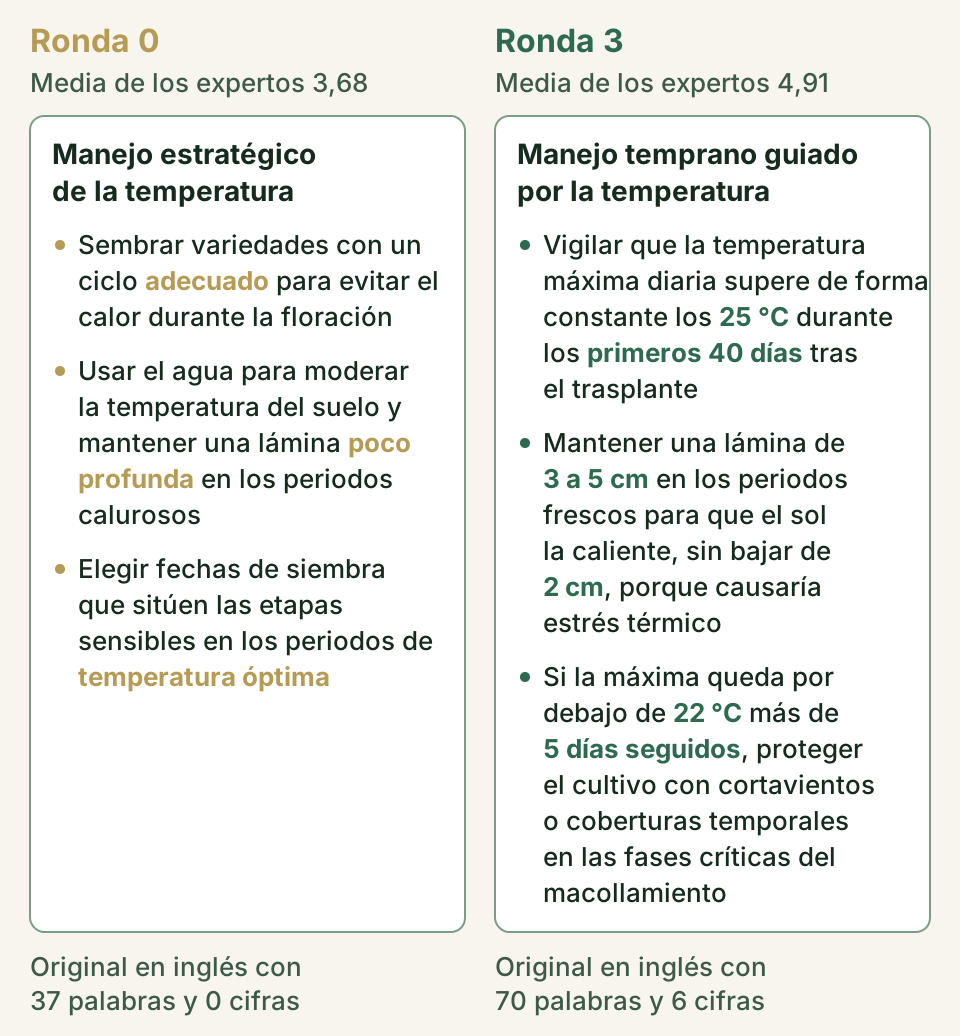
Los consejos de la figura 3 los escribió la IA. Los mostramos traducidos tal cual, sin garantizar que su contenido sea correcto.
El análisis no dejó de crecer
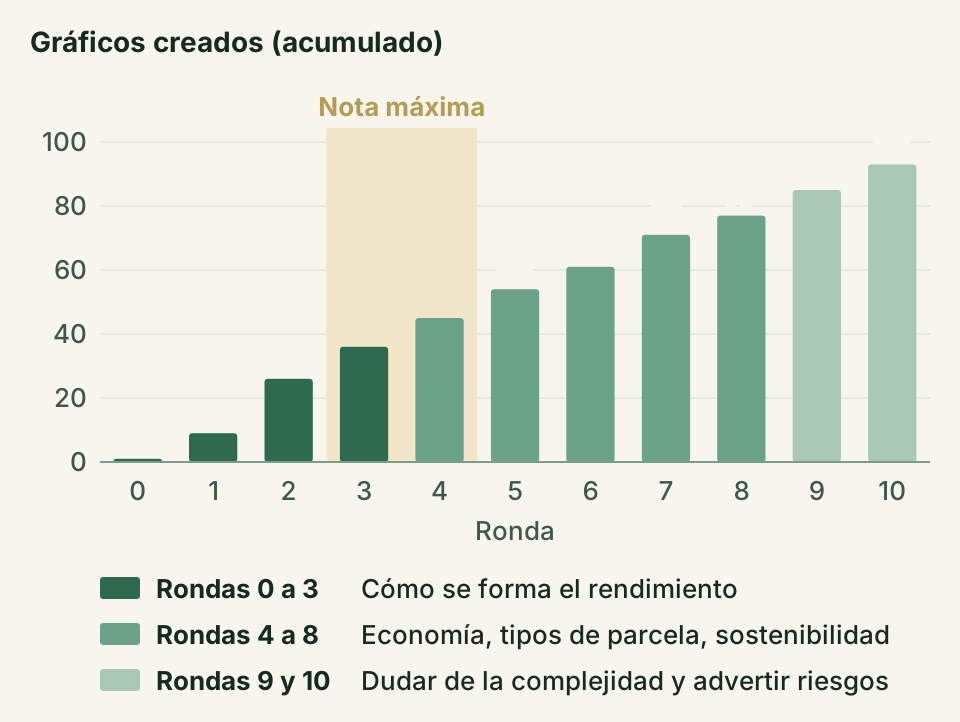
El análisis de la IA se amplió en cada ronda (figura 4). Casi siempre aparecían métodos estadísticos y tipos de gráfico nuevos, y el total de gráficos pasó de 1 en la ronda 0 a 93 en la ronda 10.
El enfoque también cambió. Las rondas 0 a 3 estudiaron cómo se forma el rendimiento y cómo interactúan el manejo y el clima. Las rondas 4 a 8 pasaron a la rentabilidad de la inversión, los tipos de parcela y la sostenibilidad a largo plazo. En las rondas 9 y 10, la IA empezó a preguntarse si tanta complejidad ayudaba de verdad a los agricultores, y se centró en resumir sus consejos con advertencias sobre los riesgos.
Cada criterio siguió su propio camino
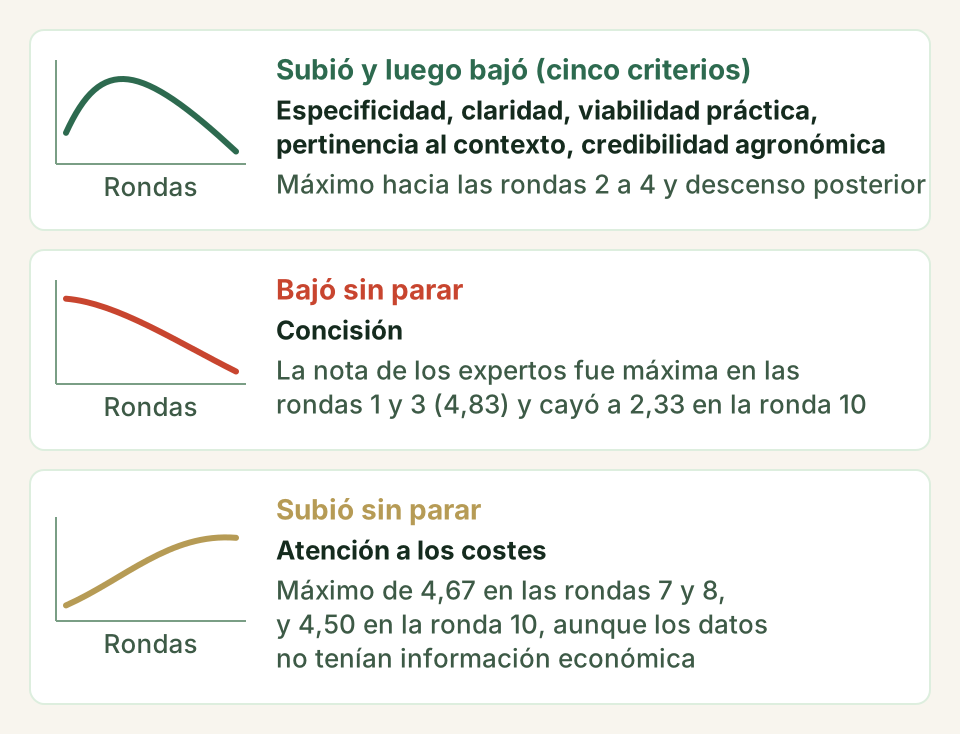
Vistos uno a uno, los siete criterios siguieron tres patrones (figura 5). La especificidad, la claridad, la viabilidad práctica, la pertinencia al contexto y la credibilidad agronómica alcanzaron su máximo hacia las rondas 2 a 4 y luego bajaron. En las notas de los LLM, la claridad fue la excepción y se mantuvo alta todo el tiempo. La concisión bajó casi desde el principio, porque los consejos eran cada vez más largos.
La atención a los costes fue el único criterio que no dejó de subir. Sin embargo, los datos no tenían ninguna información económica, ni siquiera costes o precios del arroz. La IA iba construyendo argumentos económicos que sonaban convincentes, pero que no tenían ningún respaldo en los datos.
A las primeras versiones les faltaba detalle concreto. Con demasiadas rondas, los consejos se volvieron largos y abstractos, y se llenaron de afirmaciones sin respaldo. Los mejores consejos estaban entre la explicación escasa y la excesiva. En términos de aprendizaje automático, se parece al equilibrio entre sesgo y varianza.
Los LLM fueron generosos, pero ordenaron bien las rondas
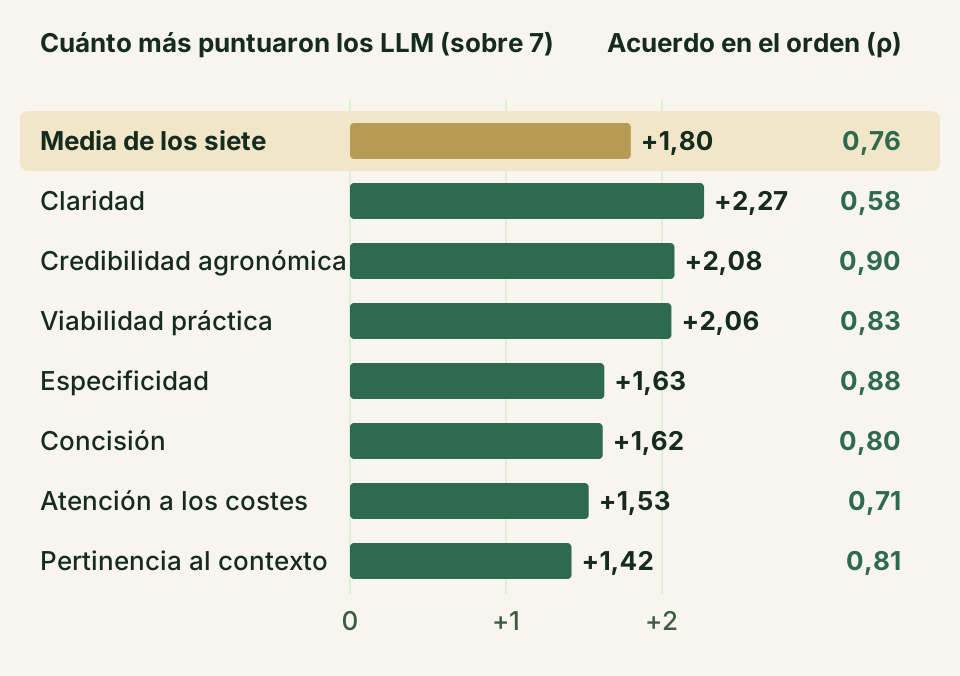
En todos los criterios, los LLM puntuaron entre 1,4 y 2,3 puntos más alto que los expertos (figura 6). En una escala de 7 puntos, es una diferencia grande, así que la nota de un LLM no puede sustituir a la de un experto.
Aun así, los dos grupos coincidieron en gran medida en qué rondas eran mejores y cuáles peores. Sus clasificaciones tuvieron una correlación de Spearman (ρ) de 0,58 a 0,90, donde 1 significa el mismo orden. Tanto en los siete criterios como en la media, la mejor ronda de un grupo nunca estuvo a más de una ronda de la del otro.
Sin embargo, cada LLM por separado se comportó de forma muy distinta. El que mejor encontró la ronda preferida por los expertos fue Gemini 3.0 Pro, que quedó a una ronda o menos en siete de las ocho notas (los siete criterios y la media). El peor fue Claude Sonnet 4, que solo lo logró en una. Claude Sonnet 4 era también la IA que había escrito los consejos. No conviene que una IA califique su propio trabajo.
Saber cuándo parar y dejar constancia
Reescribir más no hizo que los consejos fueran cada vez mejores. Mejoraron en las primeras rondas, y después se volvieron largos y abstractos, y se llenaron de contenido sin respaldo. Cualquier sistema que deje a un agente de IA pulir sus explicaciones necesita, desde el principio, un punto de parada.
Quién decide cuándo parar
Pedir a los expertos que califiquen todas las rondas les quitaría demasiado tiempo. Los LLM fueron generosos con las notas, pero distinguieron bastante bien qué rondas eran mejores. Eso indica que los LLM podrían encargarse de avisar cuándo parar.
Proponemos un procedimiento sencillo. Primero, los expertos califican una pequeña prueba, una sola vez. Después, se comparan varios LLM con esas notas y solo se conservan como jueces los que coinciden bien con los expertos. Se excluyen los modelos de la misma familia que la IA que escribe. En las ejecuciones siguientes, varios de los LLM elegidos califican cada ronda, y el ciclo se detiene cuando la nota deja de mejorar. Al final, los expertos solo revisan la versión elegida.
Publicar cada paso
El código que una IA escribe para sí misma puede tener errores. Además, en cada ronda se pide a los agricultores que confíen en más cosas a la vez. Tienen que confiar en el modelo original, en el gráfico SHAP, en el código y los análisis de la propia IA, y en los consejos que lo reúnen todo.
En este estudio publicamos las instrucciones dadas a la IA y el código, los gráficos y los consejos de cada ronda en Zenodo, un repositorio público de datos de investigación (https://doi.org/10.5281/zenodo.17876329). Creemos que los consejos de un agente de IA solo merecen confianza cuando cualquiera puede comprobar cómo se hicieron.
Lo que aún no sabemos
- Este artículo es una prepublicación. Todavía no ha pasado la revisión por pares de una revista.
- Los resultados proceden de las parcelas de una sola explotación de Fukushima. No hemos comprobado si otros cultivos o regiones muestran el mismo patrón.
- Los consejos los escribió una sola IA, Claude Sonnet 4. Los LLM evaluadores también podrían compartir sesgos, sobre todo los modelos de una misma empresa.
- Los consejos se calificaron en el momento en que se escribieron. Aún no hemos estudiado qué ocurre cuando los agricultores los siguen de verdad.
Próximos pasos
Lo más importante es que los propios agricultores evalúen los consejos, porque son ellos quienes los usarán. También queremos ver si, al llegar al máximo, darle a la IA datos nuevos o artículos publicados permite subir un escalón más. Pondremos a prueba estas ideas con otros cultivos y en otros ámbitos.
Glosario
- IA explicable (XAI)
- Métodos que muestran por qué una IA hizo una predicción, de forma que las personas puedan entenderlo.
- SHAP
- Método que mide cuánto empujó cada factor una predicción hacia arriba o hacia abajo.
- Modelo de lenguaje de gran tamaño (LLM)
- IA que aprende de enormes cantidades de texto y puede leer y escribir de forma parecida a las personas. ChatGPT, Claude y Gemini son ejemplos.
- Agente de IA
- Forma de usar la IA en la que esta trabaja por su cuenta hacia un objetivo, planificando pasos, usando herramientas y revisando sus resultados.
- XAI agéntica (Agentic XAI)
- El enfoque que propone este estudio. Un agente de IA refina una y otra vez su explicación de los resultados de la XAI en busca de una mejor.
- Aprendizaje automático (bosque aleatorio)
- El aprendizaje automático permite que un ordenador aprenda patrones a partir de datos. Un bosque aleatorio construye muchos árboles de decisión de «sí o no» y promedia sus respuestas.
- LLM como juez
- Uso de un LLM para calificar la calidad de un texto.
- Equilibrio entre sesgo y varianza
- Idea del aprendizaje automático. Un modelo demasiado simple pasa por alto patrones importantes (sesgo), y uno demasiado complejo recoge ruido aleatorio (varianza). Este estudio sugiere que el nivel de detalle de una explicación funciona de forma parecida.
- Correlación de rangos de Spearman (ρ)
- Valor que indica cuánto coinciden dos clasificaciones. Un valor de 1 significa exactamente el mismo orden.
Sobre el artículo
Tomoaki Yamaguchi, Yutong Zhou, Masahiro Ryo & Keisuke Katsura (2025). Agentic Explainable Artificial Intelligence (Agentic XAI) Approach To Explore Better Explanation: A Case Study in Decision Support for Rice Cultivation in Japan. arXiv, 2512.21066. https://doi.org/10.48550/arXiv.2512.21066
Este artículo es una prepublicación que aún no ha pasado la revisión por pares. Cualquiera puede leerlo gratis en arXiv, con la licencia CC BY 4.0. La figura 2 se reproduce del artículo, la figura 3 se adaptó de una de sus figuras y las figuras 4 a 6 se elaboraron con los valores publicados en él.