04 — Publicaciones / Explicación
Cerca de la cosecha, la IA
se fijaba en las panículas
Elegir la luz y el tamaño de imagen adecuados para cada etapa hizo más precisas las predicciones
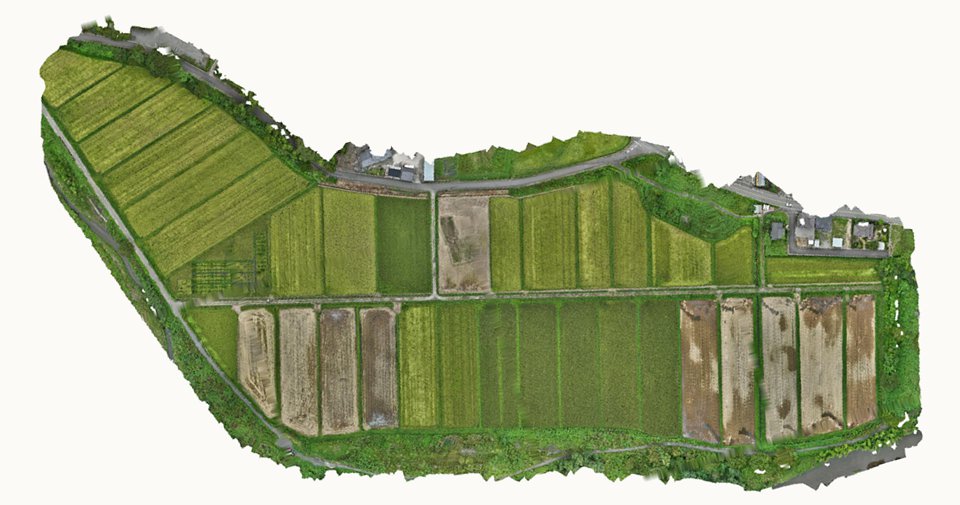
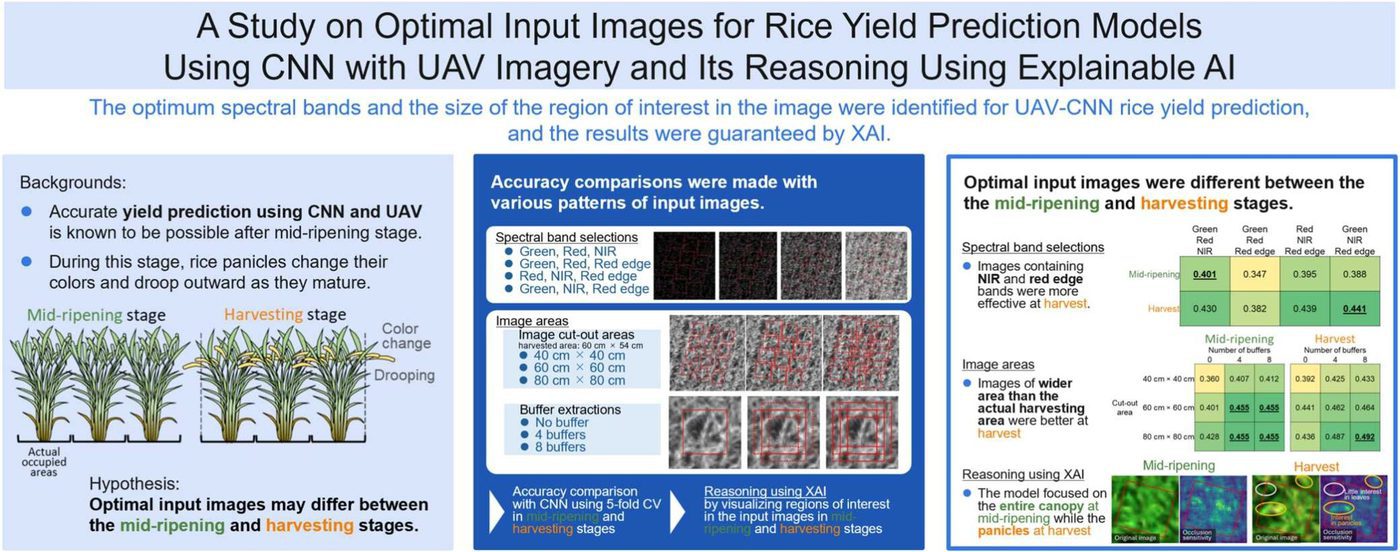
Usamos imágenes de dron de arrozales e inteligencia artificial (IA) para predecir cuánto arroz dará un campo. Esta vez cambiamos el momento de la toma, los tipos de luz de cada imagen y la superficie que abarcaba cada una, para encontrar la combinación más precisa. Cerca de la cosecha, lo mejor fue una combinación de luz que incluía el llamado borde rojo, junto con un recorte algo más amplio que la parcela cosechada. Los mapas de dónde miraba la IA mostraron que, cerca de la cosecha, se fijaba en las panículas (las espigas), lo que explica estos resultados.
Puntos clave
- La mejor combinación de luz dependió del momento en que se tomaron las imágenes. Cerca de la cosecha, el verde, el infrarrojo cercano y el borde rojo dieron las predicciones más precisas.
- Recortar cada imagen con un margen algo mayor que la parcela cosechada mejoró la precisión. La mejora fue mayor en las imágenes tomadas cerca de la cosecha.
- Los mapas de atención mostraron que la IA miraba la planta entera a mitad de la maduración (unas tres semanas después de que salen las panículas) y las panículas cerca de la cosecha, lo que explica los dos resultados anteriores.
¿Por qué predecir el rendimiento del arroz con drones e IA?
El arroz es el cultivo básico más consumido del mundo. Saber cuánto arroz producirá un campo, lo que llamamos rendimiento, es clave para las decisiones de los agricultores y para la planificación de un país.
Los drones se usan cada vez más para estimar el rendimiento. Toman imágenes detalladas cuando hacen falta, algo muy útil en Japón, donde los campos son pequeños y el tiempo suele ser nublado o lluvioso.
Para predecir el rendimiento a partir de imágenes, la IA más usada es la red neuronal convolucional (CNN, por sus siglas en inglés), un tipo de aprendizaje profundo que descubre por sí mismo los rasgos útiles de la imagen.
El arroz cambia deprisa mientras madura
Tras el espigado, cuando salen las panículas (las espigas que llevan los granos), los granos se van llenando, una etapa llamada maduración. Estudios previos con drones y CNN mostraron que las imágenes tomadas desde la mitad de la maduración en adelante dan predicciones más precisas y estables.
Sin embargo, las plantas siguen cambiando a medida que se acerca la cosecha. Los granos se llenan y las panículas se doran, mientras las hojas empiezan a secarse. Las panículas, ya pesadas, se inclinan hacia los huecos entre plantas y hacia fuera (figura 1).
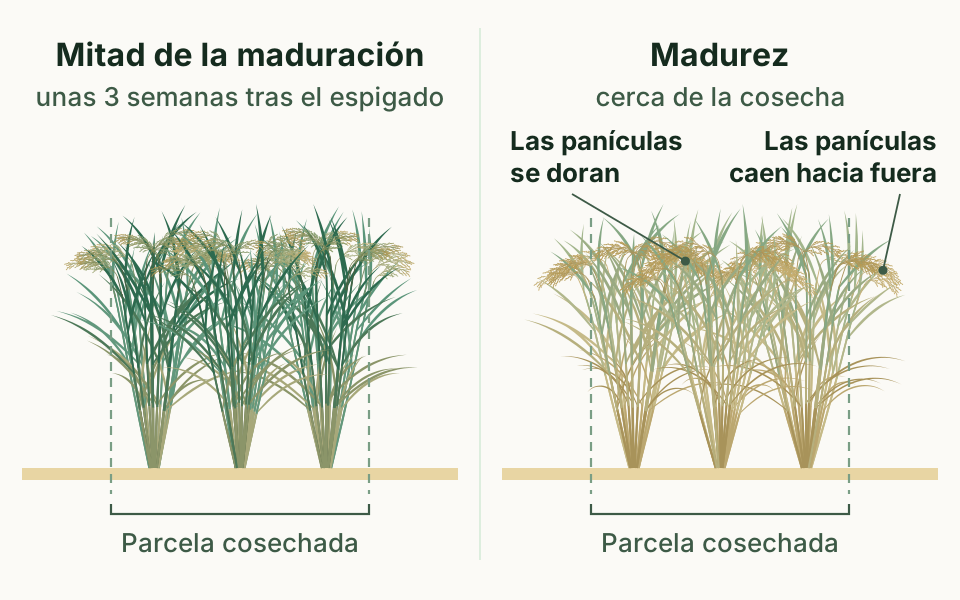
Por eso, la luz más útil y la superficie que conviene incluir en cada imagen podrían depender del momento de la toma. Estas condiciones de las imágenes de entrada no se habían estudiado en detalle.
Otro reto es que cuesta ver por qué una IA da una respuesta concreta. Los métodos que muestran las razones de una IA de forma comprensible se llaman IA explicable (XAI). En las ciencias agrarias, casi no se había aplicado la XAI a redes CNN que predicen valores numéricos, como el rendimiento.
Por eso comparamos las condiciones de las imágenes y usamos la XAI para comprobar las razones. Esperábamos que la IA se apoyara en la planta entera a mitad de la maduración y en las panículas cerca de la cosecha.
Tres años de imágenes y rendimientos, comparados en muchas condiciones
Los campos y los datos de rendimiento
Hicimos los ensayos de 2021 a 2023 en arrozales de agricultores de Tomioka, en el distrito de Futaba (prefectura de Fukushima, Japón). En 37 campos que sumaban unas 0,9 hectáreas cultivamos cinco variedades propias de la zona (Fukuhibiki, Fukunoka, Gohyakugawa, Sakurafukuhime y Tennotsubu).
Medimos el rendimiento en pequeñas parcelas de seis matas (dos hileras de tres), de 60 cm × 54 cm. Una mata es un grupo de plantas de arroz que crecen juntas. Cosechamos cada parcela, secamos las plantas en un invernadero de plástico, las trillamos y dividimos el peso del grano entre la superficie de la parcela.
En tres años reunimos el rendimiento de 2.184 parcelas. Iba de 1,3 a 13,4 toneladas por hectárea, un rango muy amplio.
Las imágenes del dron
El dron llevaba una cámara multiespectral, que registra la luz por separado para cada color o longitud de onda. También capta el infrarrojo cercano (NIR, por sus siglas en inglés), una luz que nuestros ojos no ven. Usamos luz verde, roja, de borde rojo (red edge) y NIR. El borde rojo es la estrecha franja entre el rojo y el infrarrojo cercano.
Volamos dos veces, a mitad de la maduración (unas tres semanas después del espigado y dos antes de la cosecha) y en la madurez (cerca de la cosecha). En días soleados, el dron voló a 30 o 50 metros de altura, y unimos sus fotos en una sola imagen con posiciones exactas, como un mapa, llamada ortoimagen. Cada píxel cubre unos 2 cm.
Lo que veía la IA
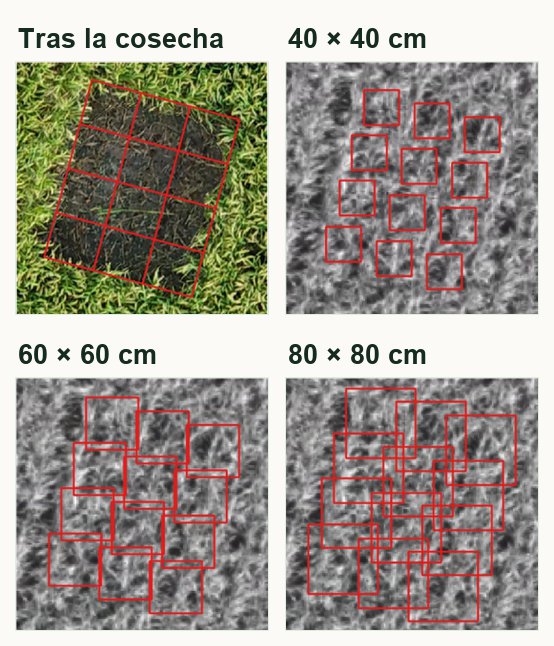
Localizamos cada parcela cosechada en una foto tomada con el dron justo después de la cosecha. Luego recortamos de la imagen del dron un cuadrado centrado en cada parcela y se lo mostramos a la IA (figura 2).
Cada cuadrado reunía tres de los cuatro tipos de luz, igual que una foto en color normal combina el rojo, el verde y el azul.
La IA que predice el rendimiento
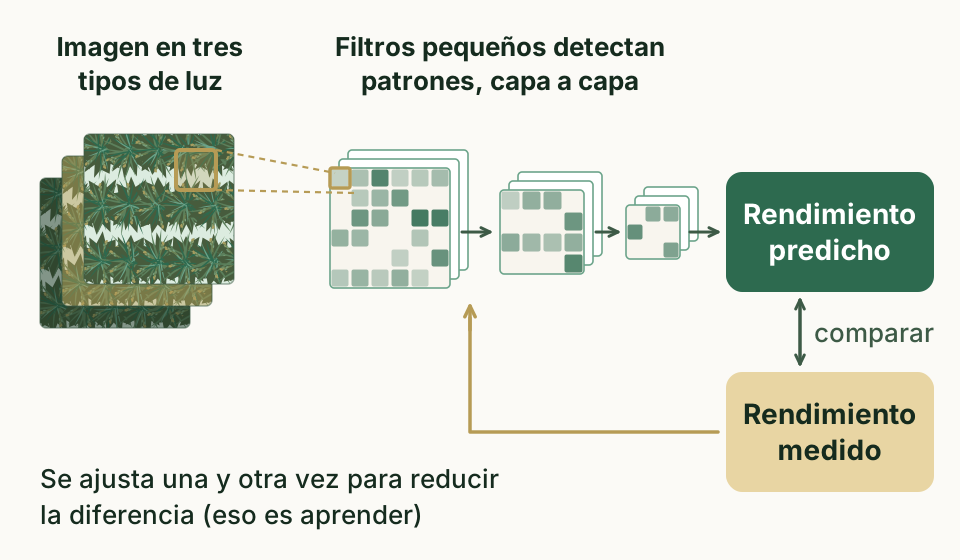
Para predecir usamos una CNN. Una CNN recorre la imagen con filtros pequeños para detectar patrones y los combina capa a capa hasta dar un solo número, el rendimiento (figura 3).
Para entrenarla, le mostramos muchas imágenes junto con el rendimiento medido en el campo. La CNN ajusta poco a poco sus valores internos para reducir la diferencia entre lo que predice y lo medido. De los tres diseños de CNN que probamos, el más preciso fue Xception.
Comprobamos la precisión solo con parcelas no usadas para entrenar. Dividimos los datos en grupos, entrenamos con todos menos uno, probamos con el que quedó fuera, repetimos con cada grupo y promediamos los resultados. Este método se llama validación cruzada.
Las cuatro condiciones que comparamos
Variamos cuatro condiciones (figura 4). La primera fue el momento, a mitad de la maduración o en la madurez. La segunda, la combinación de luz. Elegir tres de los cuatro tipos da cuatro opciones.
La tercera fue el tamaño del recorte. Probamos cuadrados de 40, 60 y 80 cm de lado, es decir, uno menor, otro casi igual y otro mayor que la parcela de 60 cm × 54 cm. Un cuadrado más amplio podría captar más información, como las panículas caídas, pero también podría incluir plantas vecinas y confundir la predicción.
La cuarta fue añadir o no copias desplazadas. Movimos el cuadrado 10 cm y dimos a la nueva imagen el mismo rendimiento que a la original (en el artículo se llama extracción con búfer). Lo desplazamos en 4 direcciones (arriba, abajo, izquierda y derecha) o en 8 (sumando las diagonales), lo que multiplicó los datos de entrenamiento por 5 o por 9.
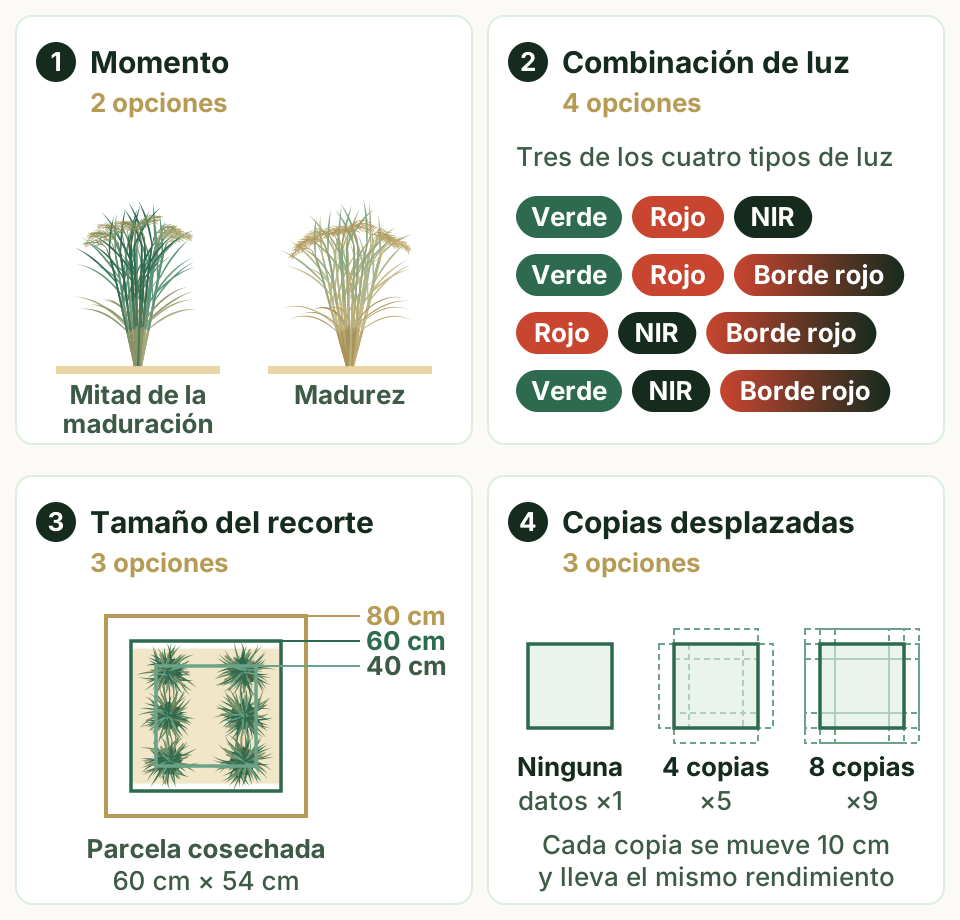
Comparamos en dos pasos. Primero, las combinaciones de luz en cada etapa. Después, con la mejor combinación de cada etapa, los tamaños de recorte y el número de copias desplazadas.
Gohyakugawa se acamó (se cayó) en casi todo el campo en 2021, así que descartamos sus datos de ese año. Como no había imágenes suyas de mitad de la maduración en otros años, esa etapa se comparó con las otras cuatro variedades.
Ver dónde miraba la IA
Para el modelo más preciso de cada etapa, usamos dos métodos para representar en mapas qué partes de la imagen usaba la IA. Estos mapas, que muestran valores con colores, se llaman mapas de calor.
El primer método es la sensibilidad a la oclusión. Borramos un punto de la imagen (ponemos su valor a cero), volvemos a predecir y vemos cuánto cambia la predicción. Cuanto mayor es el cambio, más se apoyaba la IA en ese punto. Repetimos esto en cada punto (figura 5).
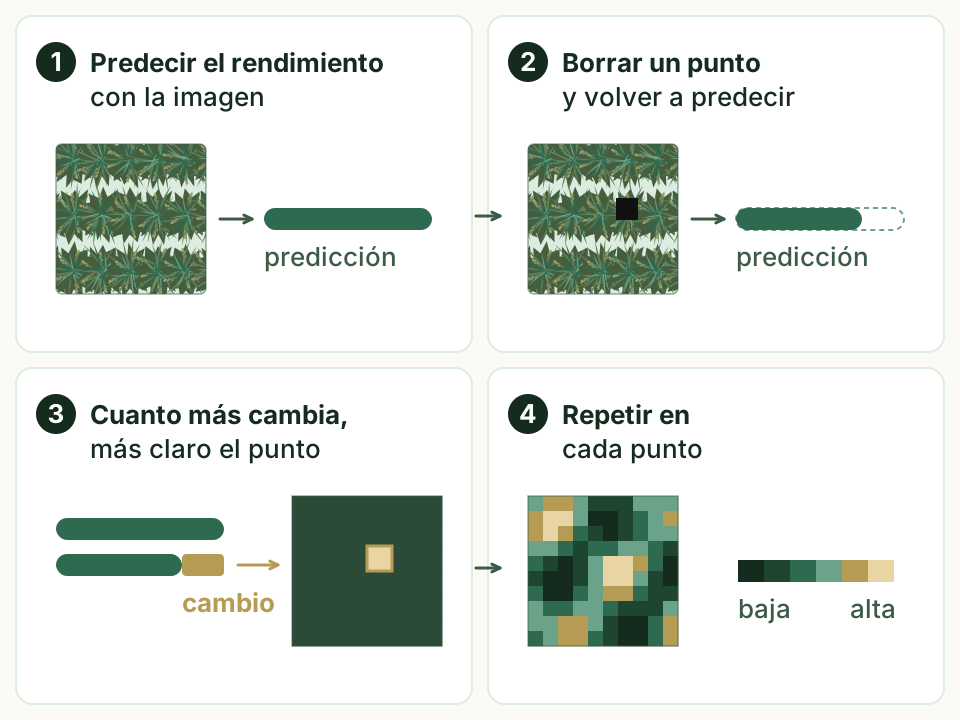
El segundo es el método del gradiente. Calcula de una sola vez cuánto cambiaría la predicción si el valor de cada punto variara un poco. Aplicamos ambos métodos a una imagen por variedad en cada etapa.
La mejor luz y el mejor tamaño de imagen dependieron de la etapa
Combinaciones de luz
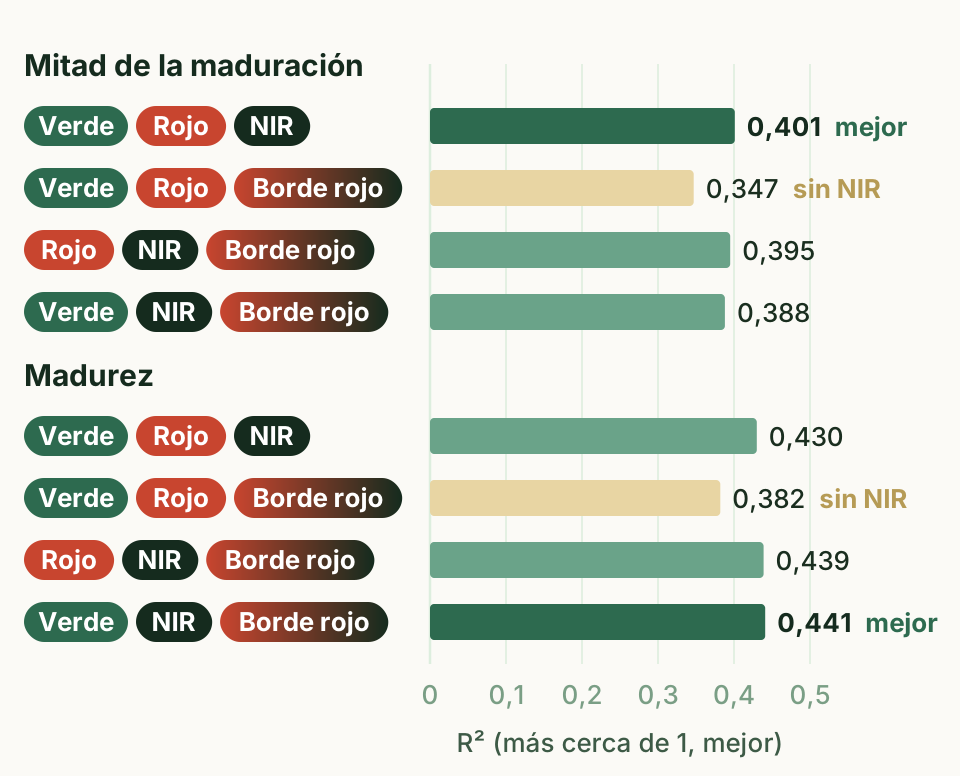
Medimos la precisión sobre todo con el coeficiente de determinación (R²). Indica cuánto se parecen las predicciones a los valores medidos, y cuanto más cerca de 1, mejor.
A mitad de la maduración, la combinación de verde, rojo y NIR fue la más precisa (R² = 0,401). En la madurez, la mejor fue verde, NIR y borde rojo (R² = 0,441).
En ambas etapas, la combinación de verde, rojo y borde rojo, la única sin NIR, dio los valores más bajos (figura 6). Se sabe que el NIR capta bien la cantidad de hojas y el tamaño de las plantas, y parece importante también para predecir el rendimiento. El borde rojo fue más útil en las imágenes de la madurez.
Tamaño del recorte y copias desplazadas
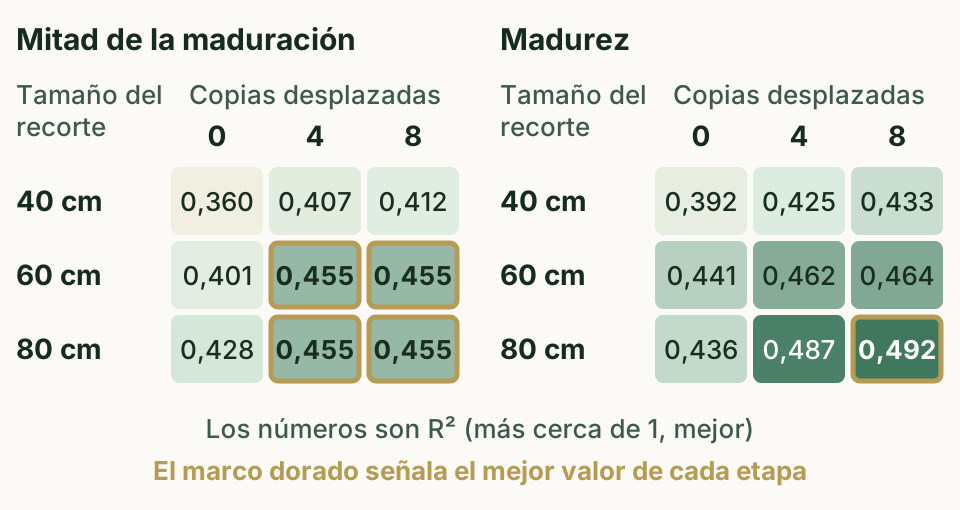
En ambas etapas, la precisión tendió a subir al ampliar el cuadrado y al añadir más copias desplazadas (figura 7).
En la madurez, el cuadrado más amplio (80 cm) con 8 copias desplazadas fue el más preciso. Su R² de 0,492 fue el más alto del estudio, y el error de predicción rondó el 15 % del rendimiento medio (RRMSE = 0,148).
A mitad de la maduración, lo mejor fueron los cuadrados de 60 u 80 cm con 4 u 8 copias desplazadas, todos con un R² de 0,455. La ventaja de un cuadrado más amplio fue mayor en la madurez.
Las plantas de arroz extienden sus hojas y panículas más allá de la parcela cosechada. Un cuadrado algo más amplio parece captar mejor las plantas de cada parcela. Hasta ahora, lo habitual era recortar las imágenes al mismo tamaño que la zona cosechada. Mostrar que un recorte algo más amplio mejora la precisión es una aportación nueva de este estudio.
Dónde miraba la IA
Los mapas de calor muestran que, a mitad de la maduración, la IA repartía su atención por igual en toda la zona con plantas. En la madurez se fijaba mucho en las panículas, mientras que en las hojas se mezclaban zonas a las que prestaba atención con otras que casi ignoraba (figura 8).
Los dos métodos mostraron el mismo patrón, que se repitió en todas las variedades aunque las fechas de vuelo variaron unos días entre variedades y años. La IA también prestó atención a panículas situadas fuera de la parcela cosechada.
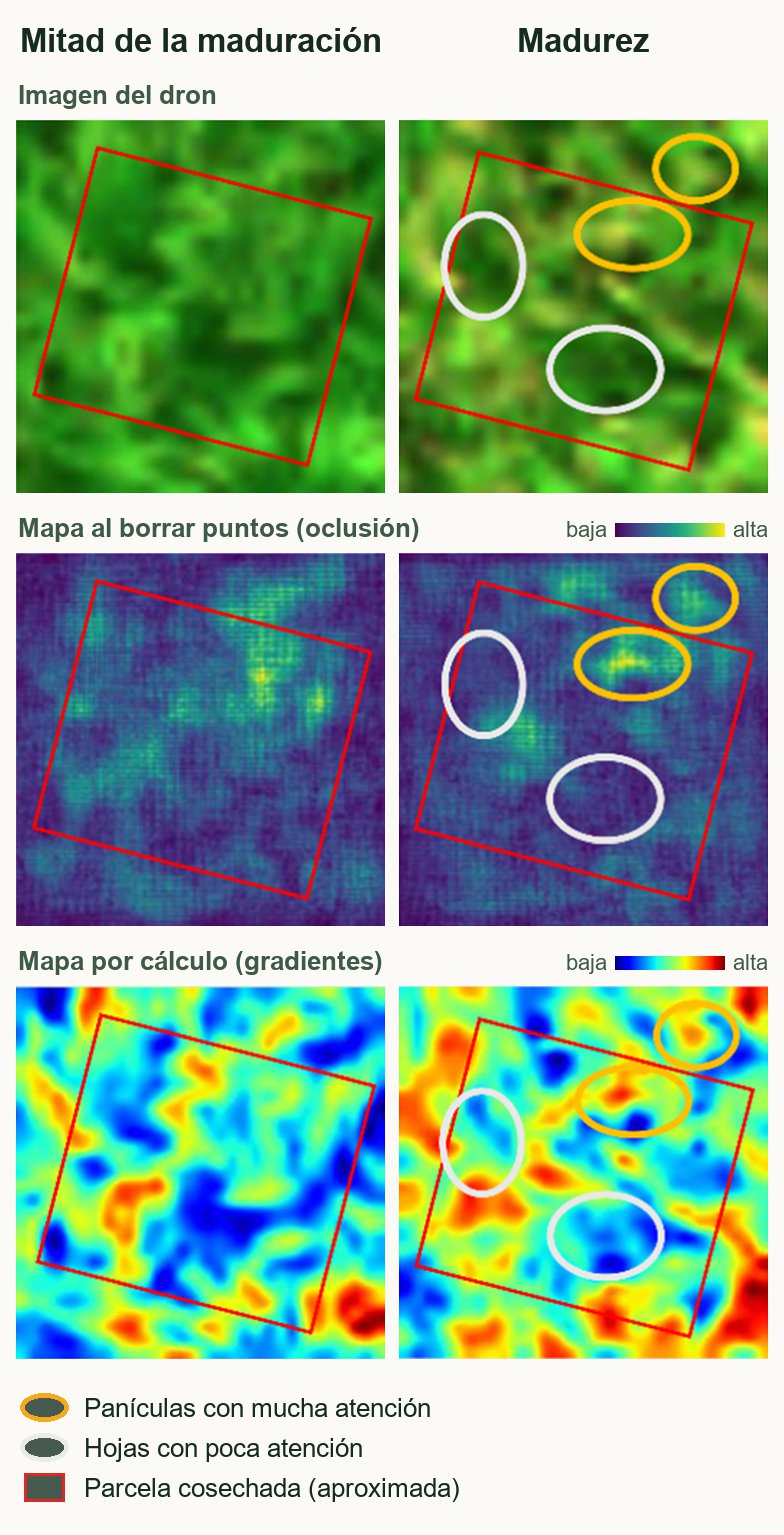
Que la IA se fijara en las panículas en la madurez encaja con los dos resultados anteriores. Otros estudios indican que el borde rojo responde a las panículas una vez que salen, cuando cambian de color y de forma. Además, un cuadrado algo más amplio recoge también las panículas que caen hacia fuera, lo que probablemente mejoró la precisión.
Hacia predicciones de rendimiento más precisas y fiables
Este estudio muestra que, al predecir el rendimiento del arroz con drones y CNN, conviene ajustar las imágenes de entrada a la etapa del cultivo. Cerca de la cosecha funcionan bien una combinación de luz con borde rojo y un cuadrado algo más amplio que la parcela cosechada.
Unas predicciones más precisas podrían ayudar a elaborar mejores mapas de rendimiento, que muestran dónde rinde más un campo y dónde menos. Conocer el rendimiento con antelación ayuda a los agricultores a tomar decisiones.
Los resultados de la XAI también importan. Si los lugares en los que se fija una IA tienen sentido según cómo crece el arroz, podemos confiar más en sus predicciones.
¿Qué precisión tiene?
Nuestros valores de R² (de 0,347 a 0,492) son más bajos que los de estudios con drones y CNN en soja y trigo, pero parecidos a los de estudios previos en arroz. Son muy superiores a los de las predicciones con índices de vegetación, medidas sencillas del verdor calculadas a partir de la luz reflejada. Nuestros datos abarcan tres años, cinco variedades y un rango amplio de rendimientos, y consideramos que esta precisión basta para comparar condiciones de imagen.
Lo que aún no sabemos
Estos resultados proceden del arroz. Aún no hemos comprobado si las mismas condiciones sirven para cultivos como el maíz o el trigo. En ellos, las espigas se inclinan menos y cambian de color de otra manera, así que las mejores condiciones también podrían ser distintas.
Además, solo tomamos imágenes en dos etapas. Otros estudios indican que combinar imágenes de más etapas mejora la precisión, pero cada vuelo adicional cuesta tiempo y dinero. Encontrar el equilibrio es una tarea pendiente.
Próximos pasos
Comprobar dónde mira una IA también puede revelar puntos débiles del modelo actual y ayudar a mejorarlo. Queremos construir modelos más fiables que, desde el punto de vista agronómico, se fijen en las partes correctas de la planta.
Glosario
- Panícula
- La espiga del arroz. Es el racimo ramificado que se forma en lo alto del tallo, donde crecen los granos, y se inclina a medida que los granos se llenan.
- Cámara multiespectral
- Cámara que registra la luz por separado para cada color o longitud de onda. También capta el infrarrojo cercano, que nuestros ojos no ven.
- Infrarrojo cercano (NIR) y borde rojo
- El infrarrojo cercano tiene longitudes de onda más largas que el rojo y es invisible para nosotros. Capta bien la cantidad de hojas y el tamaño de las plantas. El borde rojo es la franja entre el rojo y el infrarrojo cercano.
- Red neuronal convolucional (CNN)
- Tipo de IA, una forma de aprendizaje profundo, que recorre una imagen con filtros pequeños y combina en muchas capas los patrones que encuentra.
- IA explicable (XAI)
- Métodos que muestran, de forma comprensible, por qué una IA dio su respuesta. Aquí los usamos para representar en mapas dónde miraba la IA en cada imagen.
- Mapa de calor
- Mapa que muestra valores mediante colores o brillo. En este estudio, las zonas más claras o más rojas son aquellas en las que más se fijó la IA.
- Sensibilidad a la oclusión y método del gradiente
- Dos formas de averiguar dónde mira una IA. Una borra puntos uno a uno y observa cómo cambia la predicción. La otra calcula cuán sensible es la predicción a cada punto.
- Mitad de la maduración y madurez
- La maduración es la etapa posterior al espigado en la que se llenan los granos. En este estudio, la mitad de la maduración son unas tres semanas después del espigado, y la madurez, la época de la cosecha.
- Coeficiente de determinación (R²)
- Número que indica cuánto se ajustan las predicciones a las mediciones. Cuanto más cerca de 1, mejor. Un valor de 0 significa que las predicciones no son mejores que decir siempre el promedio.
- Validación cruzada
- Forma de evaluar un modelo con datos que no ha usado para aprender. Cada grupo de datos sirve por turnos como prueba y se promedian los resultados.
Sobre el artículo
Tomoaki Yamaguchi, Taiga Takamura, Takashi S.T. Tanaka, Taiichiro Ookawa & Keisuke Katsura (2025). A study on optimal input images for rice yield prediction models using CNN with UAV imagery and its reasoning using explainable AI. European Journal of Agronomy, 164, 127512. https://doi.org/10.1016/j.eja.2025.127512
El artículo es de acceso abierto, así que cualquiera puede leerlo gratis. Se publica con la licencia CC BY-NC 4.0, que permite reutilizarlo sin fines comerciales citando la fuente. Algunas figuras de esta página se elaboraron a partir de las del artículo con esa licencia.