04 — Publicaciones / Explicación
Los datos de una sola mata
sirven para entrenar modelos con drones
Una forma más ligera de reunir los datos de campo de los que aprenden los modelos
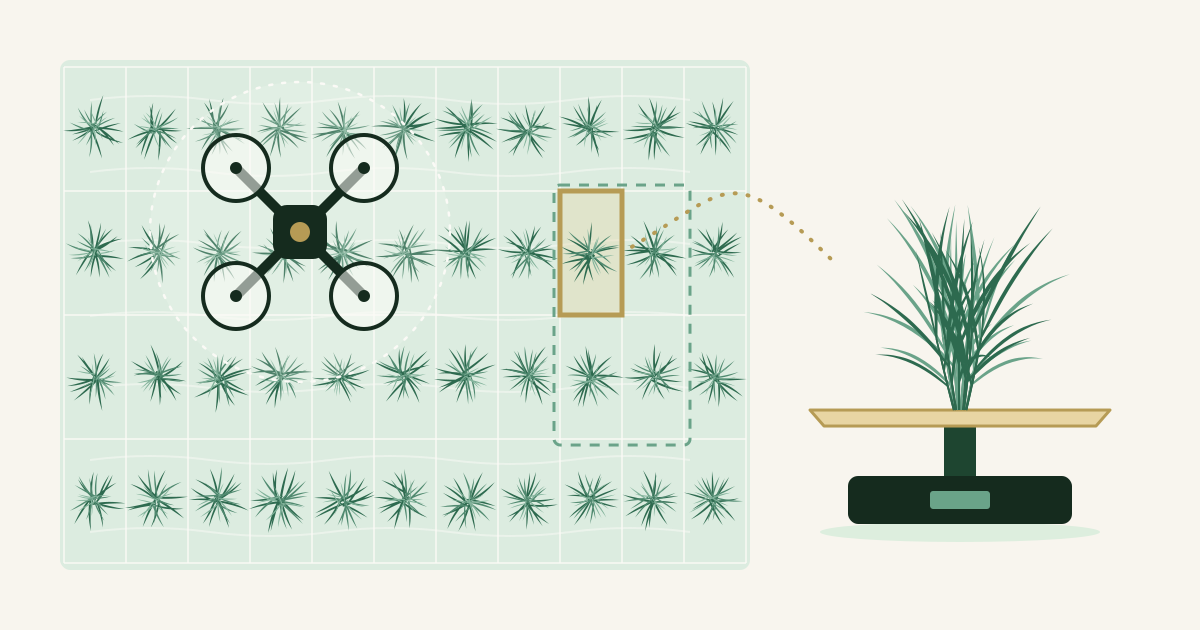
Para estimar el crecimiento del arroz con imágenes de dron, primero hacen falta mediciones de plantas cortadas en el campo, secadas y pesadas. Hasta ahora, cada dato solía ser el promedio de varias matas vecinas, es decir, de los pequeños grupos de plántulas que se trasplantan juntos. Nosotros comprobamos si medir cada mata por separado funciona igual de bien. Los modelos sencillos, basados en una sola característica, fueron igual de precisos, y al añadir más datos de una sola mata mejoraron los modelos de aprendizaje automático.
Puntos clave
- Con modelos sencillos de una sola característica, como la altura de la planta, los datos de una mata dieron casi la misma precisión que los promedios de dos o cuatro matas.
- Los datos de una sola mata tienen más ruido, y algunos métodos de aprendizaje automático perdieron precisión con ellos. Al duplicar o cuadruplicar esos datos, la mayoría de los métodos mejoró.
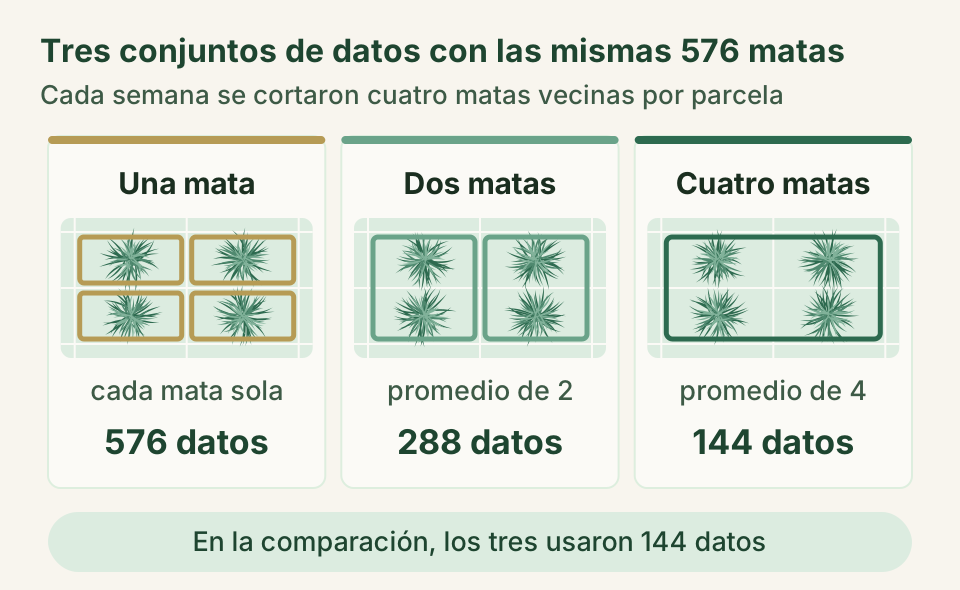
- Las mismas 576 matas cosechadas dan 576 datos si cada mata cuenta por separado, pero solo 144 como promedios de cuatro. Usar cada mata por separado podría reducir el trabajo de reunir datos de campo.
¿Por qué hay que cortar y pesar el arroz?
Dos medidas dicen mucho sobre cómo crece un cultivo de arroz. La biomasa aérea es el peso seco de todo lo que está por encima del suelo, por unidad de superficie. Ayuda a predecir el rendimiento de grano y a conocer la salud de las plantas y su contenido de nitrógeno. El índice de área foliar (LAI) compara la superficie total de las hojas con la del suelo que cubren, y refleja la capacidad del cultivo para hacer la fotosíntesis. Contar con estos valores a tiempo y con precisión es clave para los ensayos de mejora genética, el manejo de los campos e incluso la política agrícola.
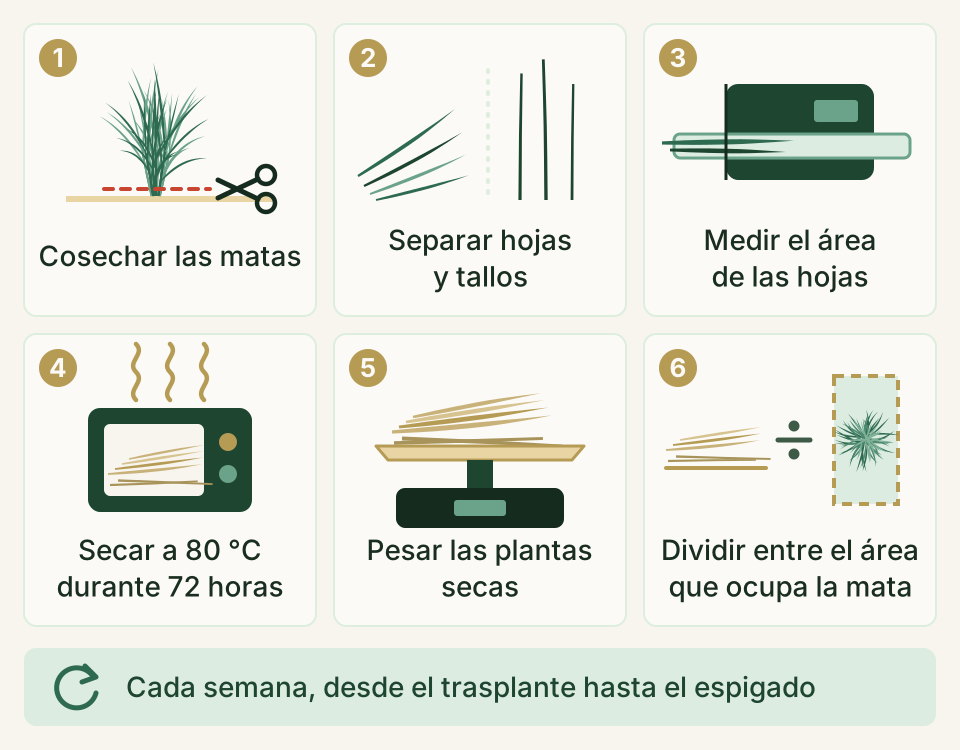
Para obtener estos valores directamente hay que cosechar plantas. En nuestro estudio, cada mata cosechada se separó en hojas y tallos, y un aparato midió el área de las hojas. Después, las muestras se secaron en una estufa a 80 °C durante 72 horas y se pesaron. Por último, dividimos entre la superficie que ocupaba la mata para obtener valores por unidad de área (figura 1). Repetimos este trabajo cada semana, desde el trasplante hasta el espigado, cuando aparecen las espigas.
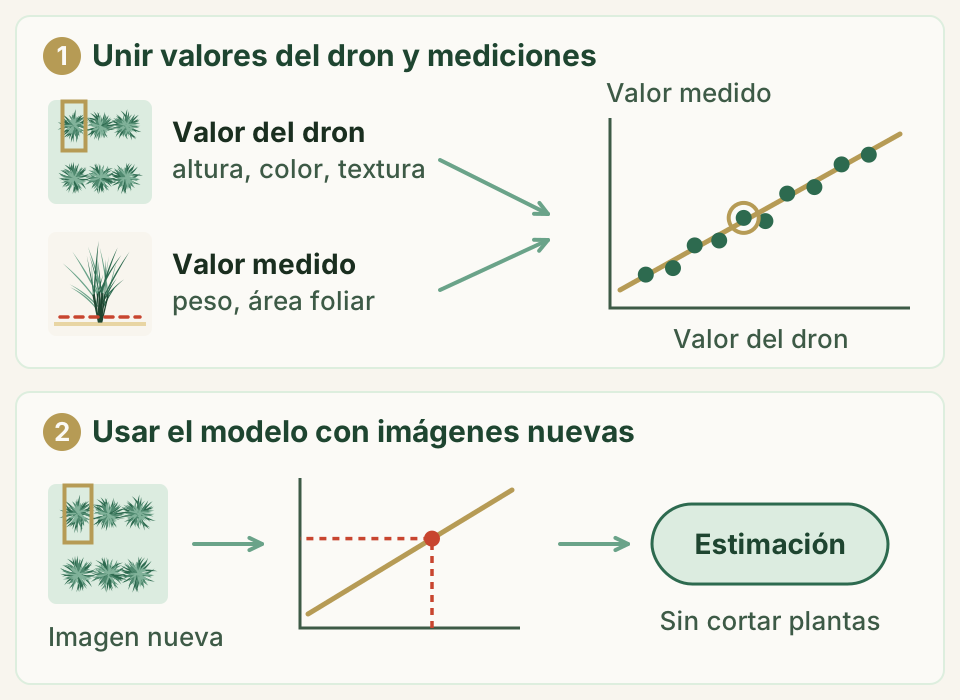
Un dron puede fotografiar un campo grande de una sola vez. Pero para convertir las imágenes en estimaciones de peso o de área foliar, primero necesitamos un modelo. Un modelo es una regla que relaciona lo que ve el dron con lo que medimos en el campo. Lo construimos a partir de muchos pares de valores del dron y mediciones a mano (figura 2). A estas mediciones se las llama datos de campo, o ground truth en inglés. Los modelos precisos necesitan muchos de estos datos, y reunirlos ha sido uno de los principales cuellos de botella de este tipo de investigación.
¿Cuántas matas hay que cortar?
En agronomía se suelen cosechar varias matas y promediarlas para obtener cada dato, porque las matas de una misma parcela crecen de forma algo distinta. Los estudios anteriores con drones usaban 4, 8 o 20 matas por dato. Si bastara con una sola mata, se podría reunir la misma cantidad de datos con menos trabajo de campo.
Sin embargo, había un problema. En las imágenes de dron, las hojas de las matas vecinas se superponen al área de cada mata. Además, las plántulas nunca quedan en una cuadrícula perfecta, así que el marco dibujado alrededor de una mata en la imagen puede no coincidir con ella. Este ruido podría pesar más cuando cada dato procede de menos matas, y nadie había comprobado todavía cuánto influye.
Comparar datos de una, dos y cuatro matas
El experimento de campo
En 2020 cultivamos la variedad de arroz Koshihikari en un arrozal de la Universidad de Agricultura y Tecnología de Tokio, en Fuchu (Tokio). Cada mata tenía tres plántulas, y las matas se plantaron con una separación de 15 cm por 30 cm. Trasplantamos en tres fechas (20 de mayo, 3 de junio y 17 de junio). La mitad de las parcelas no recibió fertilizante nitrogenado. La otra mitad recibió 2 g de nitrógeno por metro cuadrado al inicio y otros 2 g más adelante. Tres grupos de estas seis combinaciones sumaron 18 parcelas.
Cada semana, desde el trasplante hasta el espigado, un dron sobrevoló el campo a 30 m de altura. Llevaba una cámara de color normal y otra que registra por separado cinco bandas de luz, entre ellas el infrarrojo cercano. Justo después de cada vuelo, cosechamos una a una cuatro matas vecinas en cada parcela y las medimos como muestra la figura 1. En total, cosechamos 576 matas.
Leer cada mata en las imágenes
Unimos las fotos para crear un mapa del campo visto desde arriba y un modelo 3D de su superficie. Sobre el mapa colocamos un marco de 15 cm por 30 cm alrededor de cada mata y promediamos los valores de su interior (figura 3). Así obtuvimos tres tipos de características para cada mata.
- La altura de la planta se obtiene del modelo 3D. Es la altura de la superficie del cultivo el día del vuelo menos la altura del suelo antes de que crecieran las plantas.
- Los índices de vegetación combinan el brillo de distintos colores de luz y se usan mucho para seguir el crecimiento de las plantas. Calculamos 14.
- Los índices de textura convierten en números los patrones finos de luces y sombras de la imagen. Entre muchos candidatos, nos quedamos con los 8 que daban estimaciones más precisas.
Así, cada mata cosechada quedó con un par de valores, uno del dron y otro de la medición a mano.
Tres formas de construir los conjuntos de datos
Con las mismas 576 matas construimos tres conjuntos de datos (figura 4). El conjunto de una mata usa cada mata por separado. El de dos matas promedia dos matas vecinas, y el de cuatro matas promedia las cuatro, un método que también se usaba en estudios anteriores. En todos los casos, los valores del dron y las mediciones a mano se promediaron de la misma manera.
Así se obtuvieron 576, 288 y 144 datos. Para compararlos en igualdad de condiciones, elegimos al azar un dato de una mata y otro de dos matas por parcela y fecha. De este modo, cada conjunto tuvo 144 datos.
Construir y evaluar los modelos
Construimos dos tipos de modelos. La regresión simple usa una sola característica, como la altura de la planta, y ajusta una línea recta entre ella y el valor medido. El aprendizaje automático combina muchas características, y probamos 13 métodos distintos.
Evaluamos cada modelo con datos que no había visto. Las 18 parcelas formaban tres grupos, y cada grupo incluía todas las condiciones de cultivo. Entrenamos el modelo con dos grupos (96 datos) y lo evaluamos con el tercero (48 datos). Después rotamos los grupos para que cada uno sirviera una vez como prueba (figura 5). La prueba usó siempre los datos de cuatro matas, que esperábamos que tuvieran menos ruido.
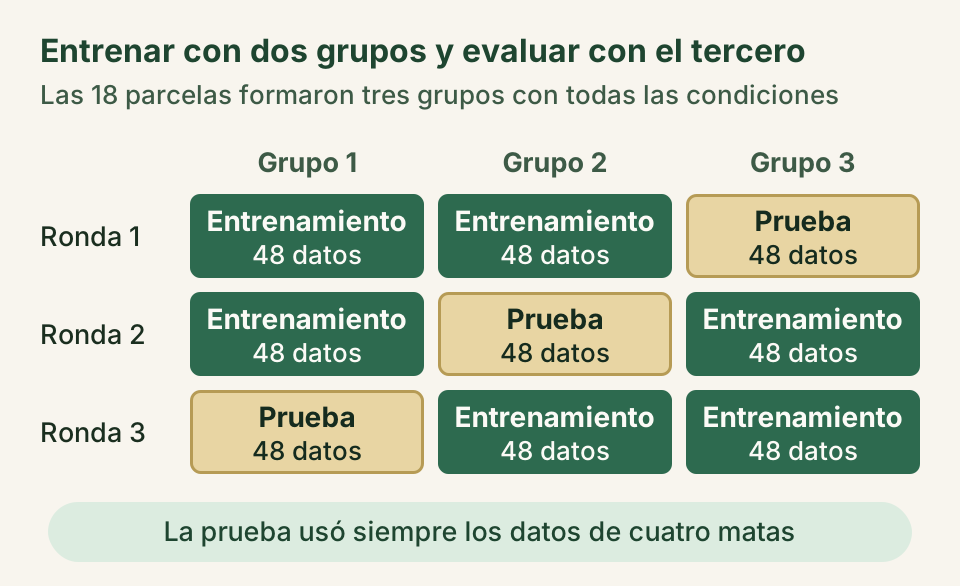
También cambiamos la cantidad de datos de entrenamiento, es decir, de los datos de los que aprende el modelo. En la regresión simple la redujimos de 96 a 32 y a 16 datos. En el aprendizaje automático duplicamos y cuadruplicamos los datos de una mata, hasta 192 y 384.
Qué cambió al usar una sola mata
Los modelos sencillos fueron igual de precisos
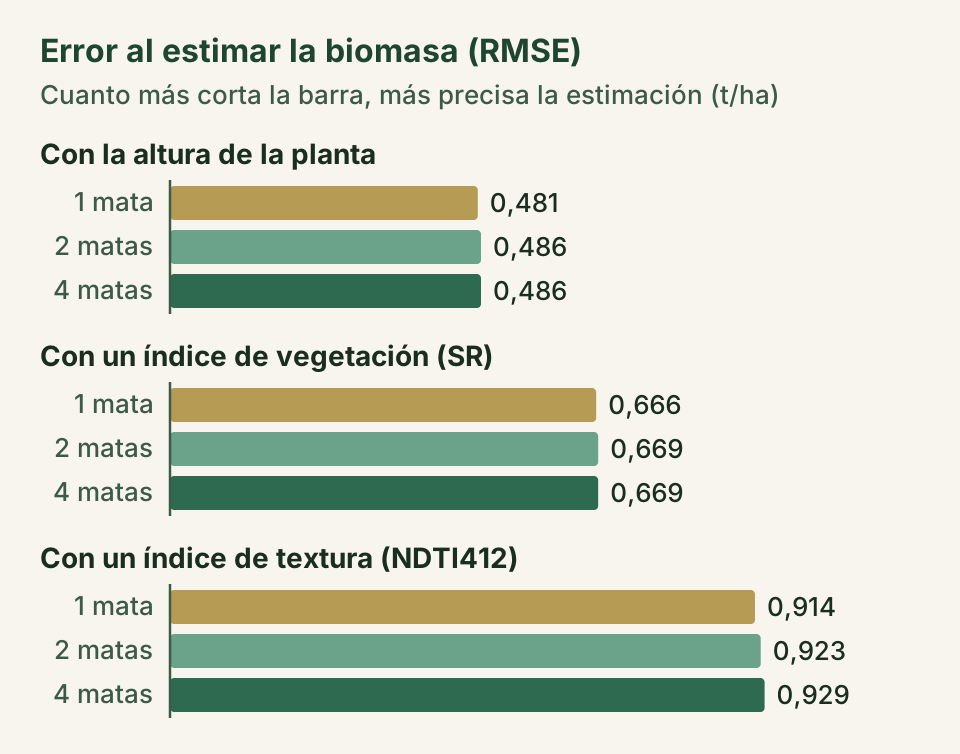
Usamos dos medidas de precisión habituales. El coeficiente de determinación (R²) indica cuánto se acercan las estimaciones a las mediciones, y 1 significa una coincidencia perfecta. El RMSE (raíz del error cuadrático medio) es el tamaño típico del error, así que cuanto menor, mejor.
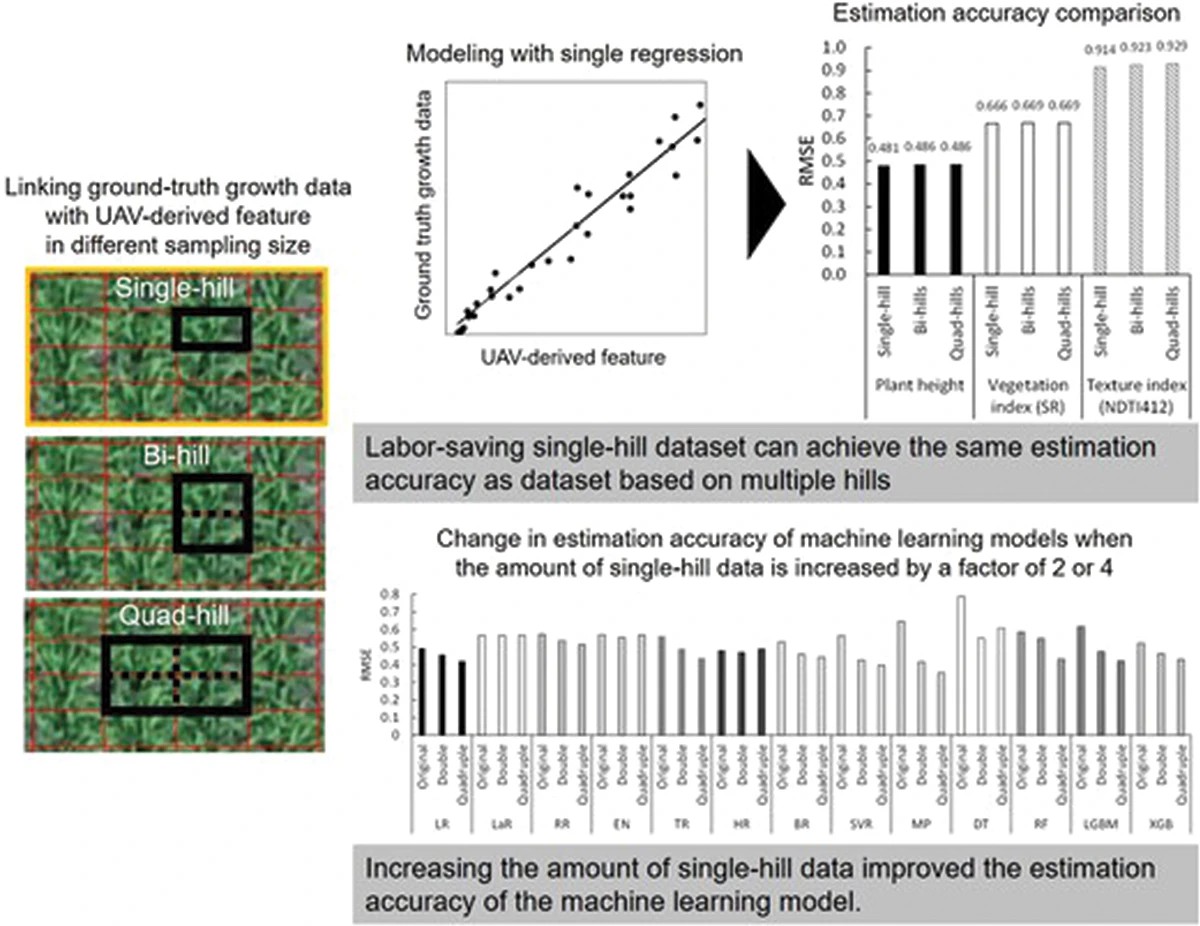
Al estimar la biomasa con la altura de la planta, el R² fue de 0,954 con una mata, 0,952 con dos y 0,954 con cuatro. El RMSE fue de 0,481 toneladas por hectárea con una mata y de 0,486 con dos y con cuatro (figura 6). Ocurrió lo mismo con los índices de vegetación y de textura, y también al estimar el índice de área foliar. El número de matas casi no influyó.
Hubo una diferencia. Durante el entrenamiento, los modelos se ajustaron peor a los datos en los conjuntos con menos matas, una señal de que los datos de una mata tienen más ruido. Aun así, los modelos terminados estimaron los datos de prueba con casi la misma precisión.
Reducir los datos de entrenamiento a 32 o a 16 tampoco abrió diferencias entre los conjuntos. Con 16 datos, la altura de la planta siguió estimando la biomasa con un R² de 0,950 con una mata, 0,953 con dos y 0,952 con cuatro. Mientras los datos de entrenamiento cubran el rango de crecimiento que se quiere estimar, la precisión no parece bajar mucho con menos datos.
Algunos métodos de aprendizaje automático notaron el ruido
Entre los 13 métodos de aprendizaje automático, los más flexibles, capaces de seguir los datos muy de cerca, tendieron a perder precisión con los datos de una mata. Entre ellos estaban una red neuronal llamada perceptrón multicapa (MP), LightGBM y XGBoost (figura 7). En general, la diferencia entre los conjuntos de una y de cuatro matas fue estadísticamente significativa.
En los conjuntos con menos matas, los errores también tendieron a crecer a medida que las plantas se hacían más grandes. Las plantas grandes se superponen más con sus vecinas y un marco algo desplazado pesa más, así que el ruido probablemente aumenta en las etapas más avanzadas. Los métodos diseñados para resistir los valores atípicos, como la regresión Lasso y la de Huber, a veces mantuvieron la misma precisión en los tres conjuntos.
Más datos de una mata mejoraron el aprendizaje automático
El aprendizaje automático suele funcionar mejor con muchos datos. Por eso entrenamos los modelos con 96, 192 y 384 datos de una mata. La mayoría de los métodos ganó precisión, y MP, LightGBM y XGBoost fueron los que más mejoraron. Las diferencias según la cantidad de datos de entrenamiento fueron estadísticamente significativas (figura 7).
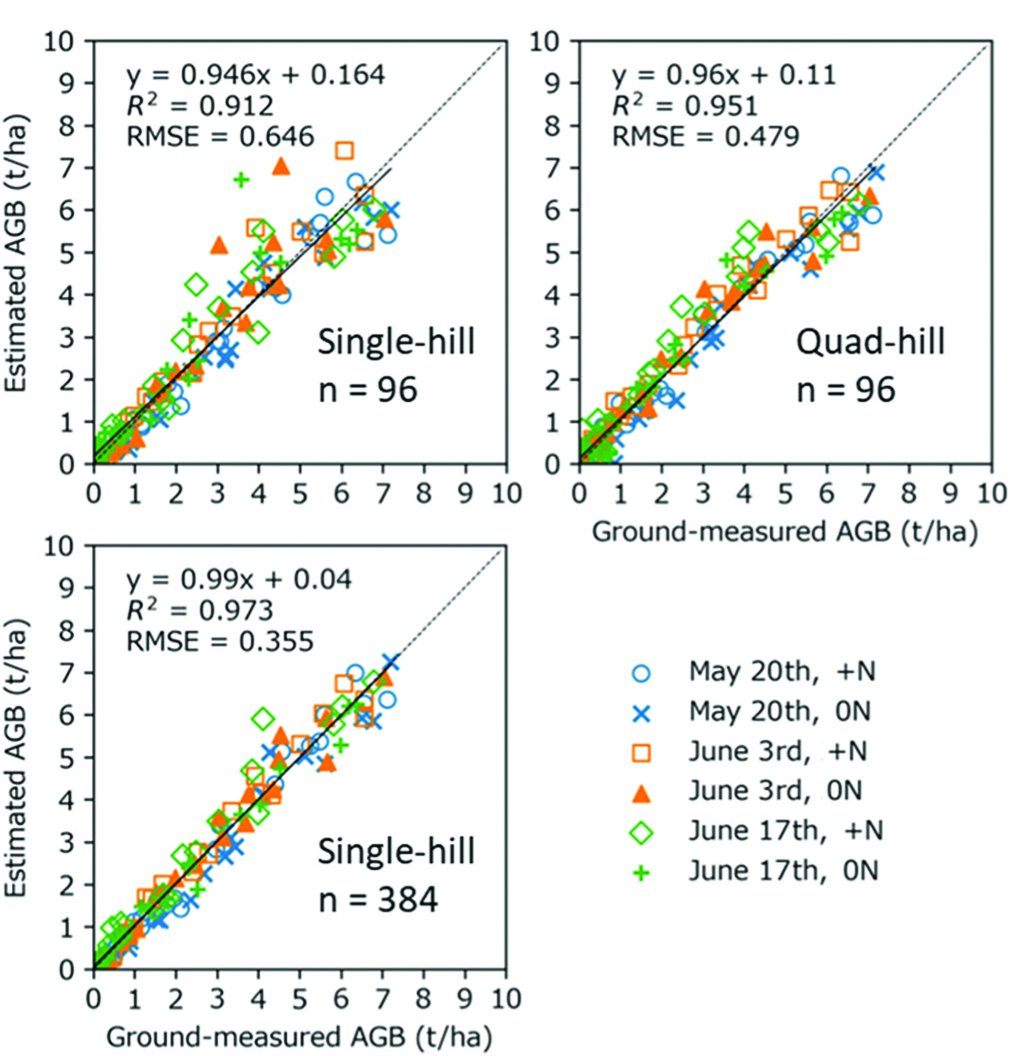
Los datos de una mata tienen algo más de ruido. Aun así, siempre que sean lo bastante fiables, reunir más datos puede hacer más precisos los modelos de aprendizaje automático.
Dónde puede ayudar y qué falta comprobar
La relación entre las imágenes de dron y el crecimiento del cultivo cambia con el ambiente, la forma de las plantas y la etapa de crecimiento. Por eso, para estimar con precisión hace falta un modelo para cada situación, y cada modelo nuevo necesita nuevos datos de campo. Nuestros resultados ayudan a aligerar ese trabajo. Los modelos de regresión simple pueden construirse con datos de una mata. Si esos datos abarcan el rango de crecimiento que se quiere estimar, podrían bastar menos datos.
Evaluamos los modelos con promedios de cuatro matas. Por eso, los resultados también muestran que un modelo entrenado con matas individuales puede estimar el crecimiento en zonas más amplias del cultivo. Esto podría ayudar a cartografiar el crecimiento en los campos de los agricultores y a comparar muchas líneas candidatas a nuevas variedades en los ensayos de mejora genética.
Para usar datos de una mata en el aprendizaje automático, conviene elegir métodos resistentes al ruido o reunir más datos.
Nuestro experimento usó una sola variedad, Koshihikari, en un solo campo y durante un solo año. La forma de las plantas cambia con la variedad y el ambiente, así que el ruido podría ser distinto en otros lugares. Aún hay que confirmar los resultados con otras variedades, lugares y años.
Hasta ahora, cada dato de campo para los modelos con drones solía salir de varias matas cosechadas. Mostramos que una sola mata también puede servir, lo que podría hacer menos laborioso reunir datos de campo para futuros modelos.
Glosario
- Datos de campo (ground truth)
- Valores medidos directamente en el campo, que se usan para construir y comprobar los modelos de estimación. En este estudio, son el peso seco y el área foliar del arroz cosechado.
- Mata
- Pequeño grupo de plántulas de arroz que se trasplantan juntas. En este estudio, cada mata tenía tres plántulas.
- Biomasa aérea
- Peso seco de las partes de la planta que están sobre el suelo, por unidad de superficie, aquí en toneladas por hectárea (t/ha). Una t/ha equivale a 100 g por metro cuadrado.
- Índice de área foliar (LAI)
- Superficie total de las hojas (una sola cara) dividida por la superficie de suelo que cubren. Es un indicador habitual de la capacidad del cultivo para hacer la fotosíntesis.
- Índices de vegetación y de textura
- Números que se calculan a partir de las imágenes de dron. Un índice de vegetación combina el brillo de distintos colores de luz, y un índice de textura describe los patrones finos de luces y sombras.
- Ruido
- Variación en los datos que no tiene que ver con el valor real. Aquí procede de las hojas vecinas que aparecen en la imagen y de los marcos que no coinciden con la mata.
- Regresión simple
- Modelo que usa una sola característica, como la altura de la planta, y ajusta una línea recta entre ella y el valor medido.
- Aprendizaje automático
- Métodos con los que un ordenador aprende, a partir de muchos ejemplos, cómo se relacionan las características con la respuesta. Pueden captar patrones complejos, pero algunos se dejan engañar fácilmente por el ruido.
- R² y RMSE
- Dos medidas de precisión. El R² (coeficiente de determinación) es mejor cuanto más se acerca a 1, y el RMSE (raíz del error cuadrático medio) es mejor cuanto más pequeño.
Sobre el artículo
Tomoaki Yamaguchi, Kana Sasano & Keisuke Katsura (2024). Improving efficiency of ground-truth data collection for UAV-based rice growth estimation models: investigating the effect of sampling size on model accuracy. Plant Production Science, 27(1), 1–13. https://doi.org/10.1080/1343943X.2023.2299641
El artículo es de acceso abierto, así que cualquier persona puede leerlo gratis. Se publica con la licencia CC BY-NC 4.0 (Creative Commons Atribución-NoComercial 4.0 Internacional). Las figuras 3 y 7 de esta página se elaboraron a partir de figuras del artículo, y la figura 8 es su resumen gráfico. Todas se usan con esa licencia.