04 — 論文 / やさしい解説
1株ずつ測ったデータからでも、
ドローンで生育を推定できる
ドローンで推定するための実測データを、少ない手間で集める
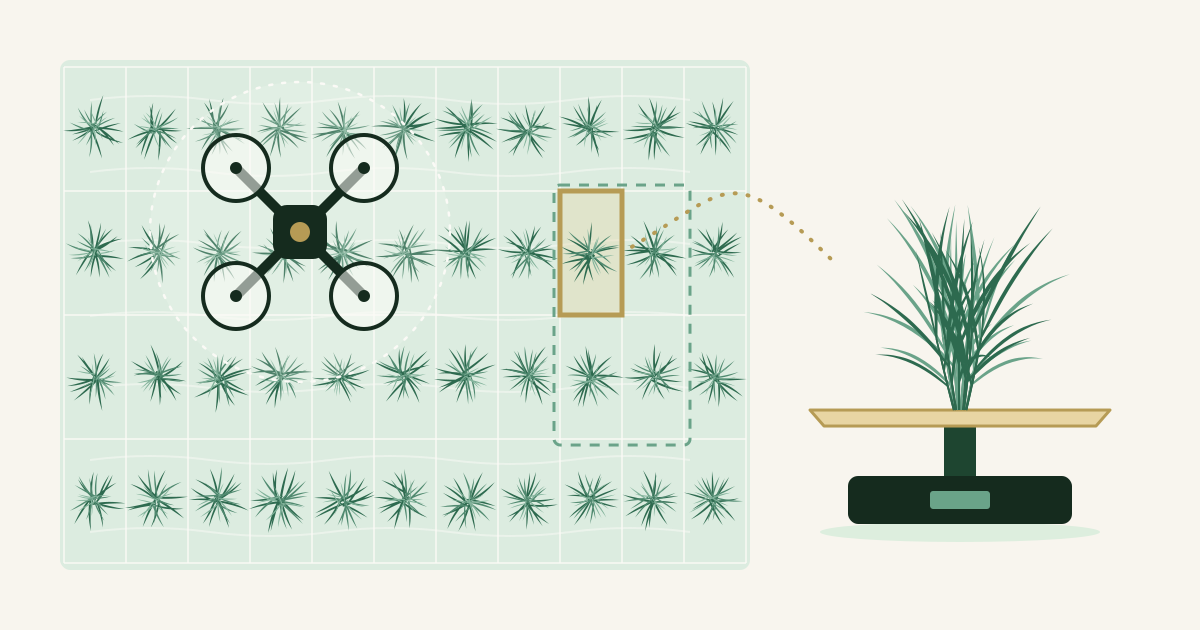
ドローンの画像からイネの育ちを推定するには、田んぼでイネを刈り取り、重さや葉の面積を実際に測ったデータが欠かせません。これまでは何株かをまとめて刈り取り、その平均を1つのデータとしてきました。私たちは、1株ずつ測ったデータでも同じように推定できるかを調べました。その結果、単純な推定式では精度がほぼ変わらず、1株ずつのデータを増やすと機械学習の精度も上がりました。
この研究のポイント
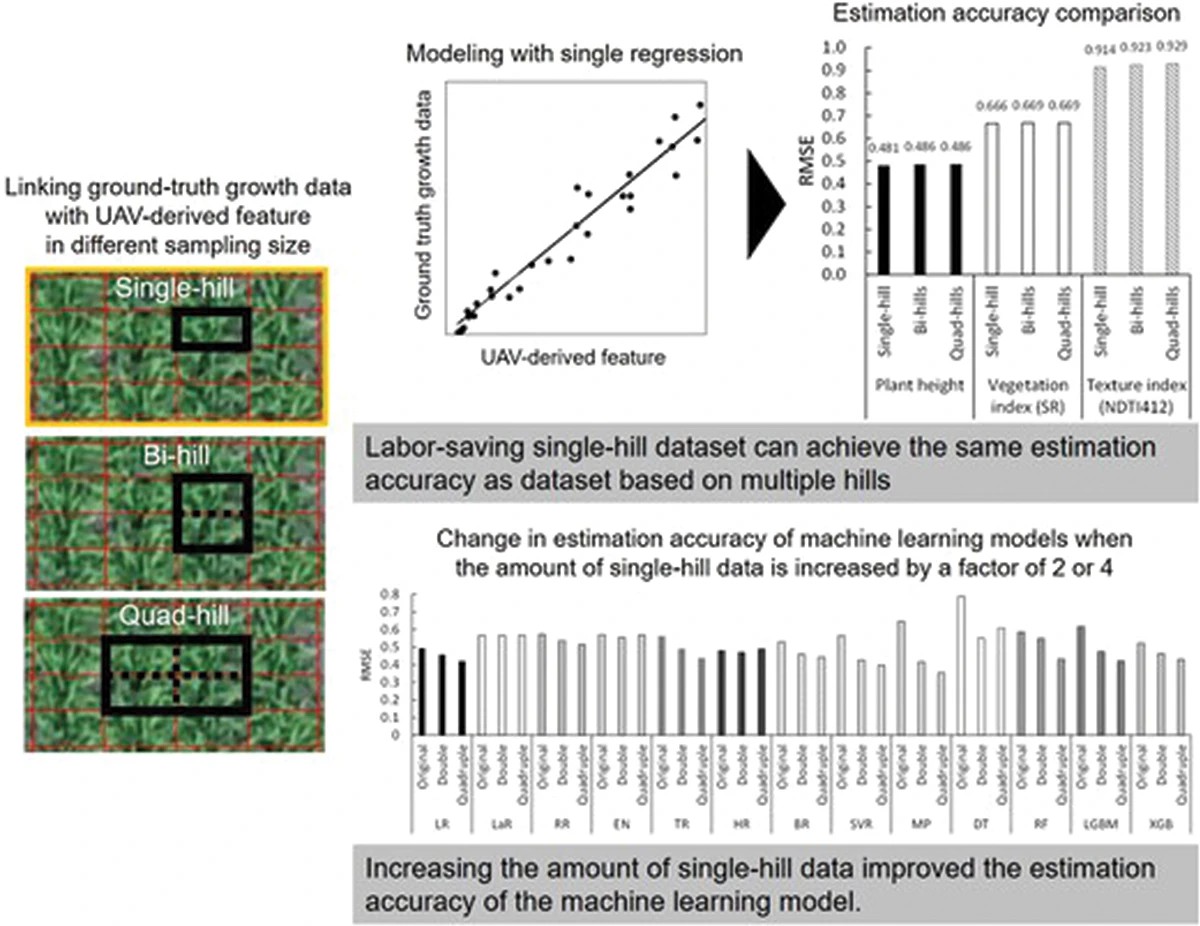
- 草高など1つの特徴から推定する方法(単回帰)では、1株ずつのデータでも、2株や4株の平均とほぼ同じ精度になりました。
- 機械学習では、乱れの多い1株ずつのデータを使うと、精度が下がる手法もありました。それでもデータを2倍、4倍に増やすと、ほとんどの手法で精度が上がりました。
- 同じ576株を刈り取っても、1株ずつ扱えばデータは576点、4株の平均では144点です。1株ずつのデータが使えれば、地上での測定の手間を減らせる可能性があります。
なぜ、イネを刈り取って測るのか
イネの育ち具合を表すものさしに、地上部バイオマスと葉面積指数(LAI)があります。地上部バイオマスは、イネの地上に出ている部分を乾かして量った重さです。収量を予測したり、イネの健康状態や窒素の量を知ったりする手がかりになります。葉面積指数は、葉の面積の合計が地面の面積の何倍かを表す値で、光合成の力の目安になります。どちらも、育種(品種改良)の試験や田んぼの管理、農業の政策づくりなどに欠かせない情報です。
これらを直接測るには、田んぼからイネを刈り取らなければなりません。刈り取った株を葉と茎に分け、葉の面積を機械で測ります。次に乾燥機に入れ、80 °Cで72時間乾かしてから重さを量ります。最後に、株が占めていた面積で割り、面積あたりの値にします(図1)。私たちの実験では、この作業を田植えから穂が出るまで、毎週くり返しました。
ドローンを使えば、広い田んぼを一度に撮影できます。ただし、画像から重さや葉の面積を推定するには、推定のための式(モデル)を先に作る必要があります。モデルは、画像から求めた値と実測値の組をたくさん集め、両者の関係から作ります(図2)。この実測値を、グラウンドトゥルースと呼びます。正確なモデルには多くの実測値が必要で、それを集める手間が、研究の大きな負担になってきました。
何株を刈り取ればよいのか
これまでの研究では、1つのデータを作るために、複数の株を刈り取って平均してきました。同じ区画の中でも、株ごとに育ちが少しずつ違うためです。刈り取る株の数は、研究によって4株、8株、20株などとさまざまでした。もし1株ずつのデータで足りるなら、同じ数のデータを、少ない作業で集められます。
ただし、心配な点もありました。ドローンの画像では、となりの株から伸びた葉が、1株の範囲に重なって写ります。また、植えた位置が少しずつずれるため、画像の上に置いた枠と株の位置が合わないこともあります。こうした乱れ(ノイズ)の影響は、少ない株から作ったデータほど大きくなるおそれがあります。その程度は、まだわかっていませんでした。
1株・2株・4株のデータで、推定の精度を比べる
田んぼでの実験
実験は2020年に、東京農工大学の水田(東京都府中市)で行いました。品種はコシヒカリで、1株に3本の苗を、15 cm × 30 cmの間隔で植えました。田植えの日は、5月20日、6月3日、6月17日の3通りです。また、窒素肥料を与えない区画と、与える区画(はじめの元肥と、あとから足す追肥に、1 m²あたり2 gずつ)を設けました。この6通りの組み合わせを3組ずつ用意し、合わせて18の区画で育てました。
田植えから穂が出るまで、週に1回、ドローンで田んぼを撮影しました。高さ30 mから、ふつうのカラーカメラと、近赤外線を含む5種類の光を分けて記録するマルチスペクトルカメラで撮りました。撮影のすぐあとに、各区画でとなり合う4株を1株ずつ刈り取り、図1の手順で測りました。刈り取った株は、合わせて576株です。
画像から、株ごとの特徴を取り出す
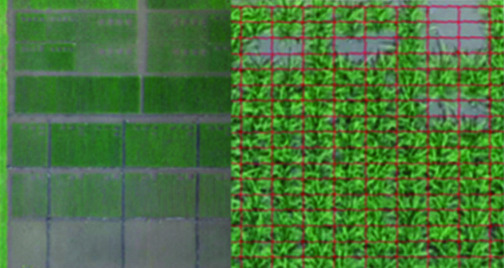
撮影した写真をつなぎ合わせて、田んぼを真上から見た画像と、立体の形を作りました。画像の上には、1株ごとに15 cm × 30 cmの枠を置き、枠の中の値の平均を求めました(図3)。こうして、株ごとに次の3種類の特徴を得ています。
- 草高は、イネの高さです。撮影した日の立体の形から、イネが育つ前の地面の高さを引いて求めました。
- 植生指数は、色ごとの光の強さを組み合わせた数値で、植物の茂り具合を表すのに使われます。14種類を計算しました。
- テクスチャ指数は、画像の明るさの細かな模様(きめ)を数値にしたものです。多くの組み合わせから、推定の精度が高い8種類を選んで使いました。
これで、1株ごとに、ドローンの値と実測値の組ができました。
3通りのデータを用意する
同じ576株から、作り方の違う3通りのデータを用意しました(図4)。1株のデータは、1株ごとの値をそのまま使います。2株のデータは、となり合う2株の平均です。4株のデータは、となり合う4株の平均で、これまでの研究にも使われてきた作り方です。ドローンの値と実測値の両方を、同じように平均しています。
データの数は、1株が576点、2株が288点、4株が144点になります。比べるときは、条件をそろえました。1株と2株のデータからは、区画と撮影日ごとに1点を無作為に選び、どれも144点にしています。
推定の方法と、精度の確かめ方
推定には、2つの方法を使いました。1つは、草高など1つの特徴だけを使い、実測値との関係を1本の直線で表す単回帰です。もう1つは、多くの特徴を組み合わせて使う機械学習で、13の手法を試しました。
精度は、モデル作りに使わなかったデータで確かめます。18の区画は、すべての条件を含む3つの組に分かれています。そこで、2組(96点)でモデルを作り、残りの1組(48点)でテストしました。これを、組を入れかえて3回くり返しています(図5)。テストには、乱れが最も少ないと考えられる4株のデータを、いつも使いました。
さらに、モデル作りに使うデータ(学習データ)の数も変えてみました。単回帰では、96点を32点と16点に減らしました。機械学習では、1株のデータを192点と384点に増やし、2倍、4倍にしています。
1株ずつのデータで、精度はどう変わったか
単回帰では、株の数による差がほとんどない
精度の目安には、2つの数値を使いました。決定係数(R²)は、推定値と実測値がどれだけよく合うかを表し、1に近いほど正確です。RMSE(二乗平均平方根誤差)は、推定値と実測値のずれの大きさを表し、小さいほど正確です。
草高から地上部バイオマスを推定したとき、R²は1株のデータで0.954、2株で0.952、4株で0.954でした。RMSEは同じ順に0.481、0.486、0.486 t/haで、10 aあたり48.1〜48.6 kgにあたります(図6)。植生指数やテクスチャ指数を使っても、葉面積指数を推定しても、株の数による差はほとんどありませんでした。
一方で、モデルを作るときの当てはまりは、株の数が少ないデータほど悪くなりました。1株ずつのデータには、乱れが多いと考えられます。それでも、できあがったモデルで推定した精度には、ほとんど差がありませんでした。
学習データを32点、16点に減らしても、株の数による差は大きくなりませんでした。16点の場合も、草高から地上部バイオマスを推定したR²は、1株で0.950、2株で0.953、4株で0.952でした。推定したいイネの育ちの幅を学習データが含んでいれば、データが少なくても精度はあまり下がらないと考えられます。
機械学習では、乱れの影響を受ける手法もある
13の手法のうち、データに細かく合わせる力の強い手法では、1株のデータを使うと精度が下がる傾向がありました。ニューラルネットワークの一種であるMP(多層パーセプトロン)や、LightGBM、XGBoostなどです(図7)。全体として、1株と4株のデータの間には、統計的に意味のある差(有意差)がありました。
株の数が少ないデータでは、イネが大きくなるほど、推定のずれが広がる傾向もありました。育ったイネではとなりの株の葉が重なりやすく、枠のずれも影響しやすいためと考えられます。一方、外れた値に左右されにくい手法(ラッソ回帰やHuber回帰など)では、株の数によらず精度がそろう場合もありました。
1株のデータを増やすと、機械学習の精度が上がる
機械学習は、データが多いほど力を発揮します。そこで、学習に使う1株のデータを、96点、192点、384点と増やして比べました。その結果、ほとんどの手法で精度が上がりました。特にMP、LightGBM、XGBoostで大きく改善し、データの数による差は統計的にも有意でした(図7)。
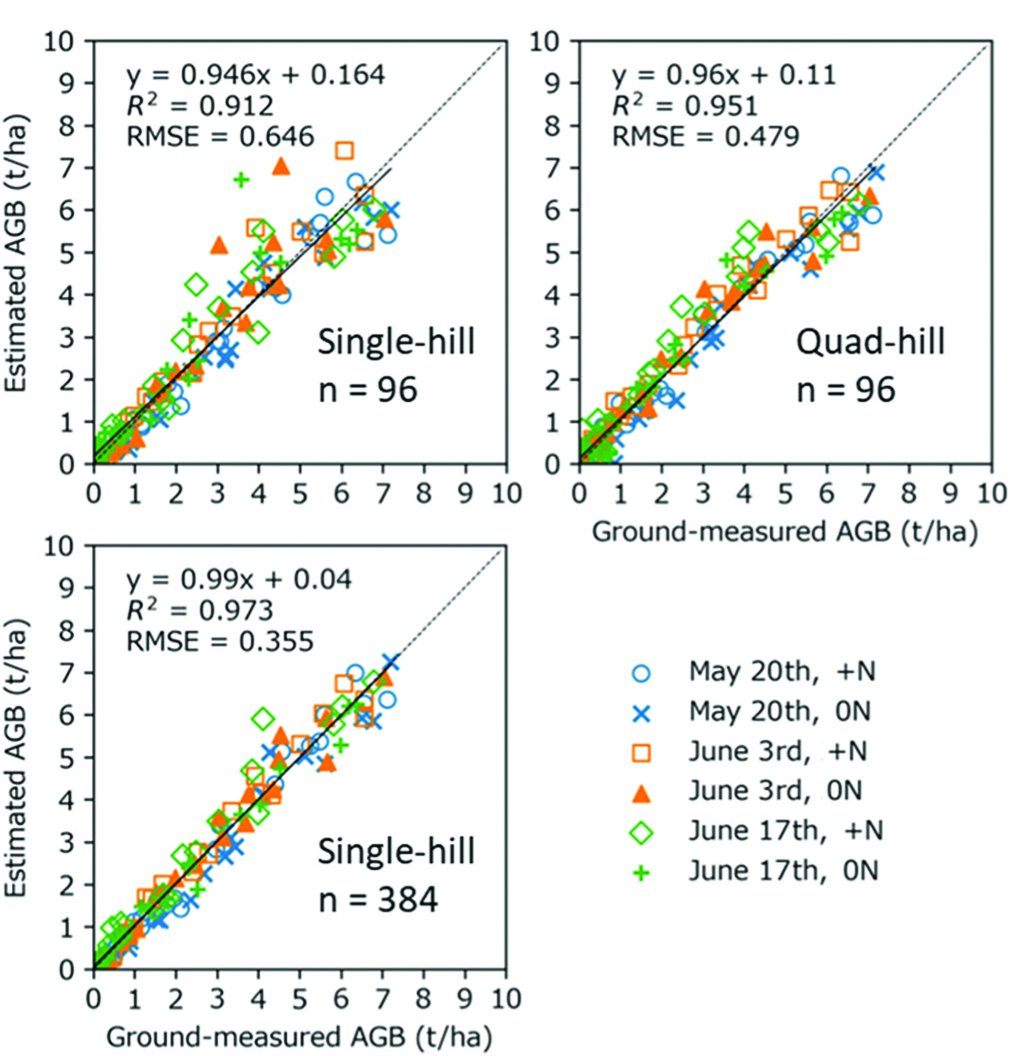
1株ずつのデータには、少し乱れが含まれます。それでも、十分に信頼できるデータであれば、数を集めることで機械学習の精度を高められます。
結果が役立つ場面と、残された課題
ドローンの画像とイネの育ちの関係は、環境やイネの姿、生育の時期によって変わります。そのため、正確に推定するには条件ごとにモデルを作る必要があり、そのたびに実測値を集めなければなりません。この研究の結果は、その作業を効率よく進める助けになります。単回帰なら、1株ずつのデータでもモデルを作れます。推定したい育ちの幅を含んでいれば、学習データの数も減らせる可能性があります。
また、この研究のモデルは、4株の平均のデータでテストしました。つまり、1株ずつのデータで作ったモデルでも、何株もまとまった範囲の推定に使えることが示されました。たとえば、農家の田んぼ全体の生育の推定や、多くの系統(品種の候補)を比べる育種の試験で、役立つと考えています。
機械学習で1株のデータを使うときは、乱れに強い手法を選んだり、データの数を増やしたりすると効果的です。
ただし、この結果は、1つの品種(コシヒカリ)を1か所で1年だけ育てて得たものです。環境や品種が違えばイネの形も変わるため、乱れの大きさも変わるかもしれません。ほかの品種や地域、年でも同じ結果になるかは、これから確かめる必要があります。
これまで、ドローンの推定モデルに使う実測データは、複数の株を刈り取って作るのがふつうでした。この研究は、1株ずつのデータも使える可能性を示しました。実測の手間を減らす、大切な手がかりになると考えています。
用語の解説
- グラウンドトゥルース
- 推定のモデルを作ったり確かめたりするために、現地で実際に測った値です。この研究では、刈り取ったイネの重さと葉の面積を指します。
- 株
- 田植えで1か所に植えた苗が育った、イネのまとまりです。この研究では、1株に3本の苗を植えました。
- 地上部バイオマス
- イネの地上に出ている部分を乾かして量った重さを、面積あたりで表した値です。単位のt/haは1ヘクタールあたりのトン数で、1 t/haは10 aあたり100 kgにあたります。
- 葉面積指数(LAI)
- 葉の面積(片面)の合計が、地面の面積の何倍あるかを表す値です。光合成の力の目安になります。
- 植生指数・テクスチャ指数
- どちらも、ドローンの画像から計算する数値です。植生指数は色ごとの光の強さを組み合わせたもの、テクスチャ指数は画像の明るさの模様(きめ)を表したものです。
- ノイズ(乱れ)
- 本来の値とは関係のない、データのずれやゆらぎです。この研究では、となりの株の葉が写り込むことや、枠と株の位置のずれが原因になります。
- 単回帰
- 1つの特徴(たとえば草高)と実測値の関係を、1本の直線で表す方法です。
- 機械学習
- たくさんのデータから、特徴と答えの関係をコンピューターに学ばせる方法です。複雑な関係も表せますが、手法によってはデータの乱れに引きずられやすくなります。
- R²とRMSE
- どちらも推定の精度を表す数値です。R²(決定係数)は1に近いほど正確です。RMSE(二乗平均平方根誤差)は推定値と実測値のずれの大きさで、小さいほど正確です。
論文の情報
Tomoaki Yamaguchi, Kana Sasano & Keisuke Katsura (2024). Improving efficiency of ground-truth data collection for UAV-based rice growth estimation models: investigating the effect of sampling size on model accuracy. Plant Production Science, 27(1), 1–13. https://doi.org/10.1080/1343943X.2023.2299641
オープンアクセスの論文で、誰でも無料で読めます。ライセンスはCC BY-NC 4.0(クリエイティブ・コモンズ 表示-非営利 4.0 国際)です。このページの図3と図7は論文の図をもとに作成したもの、図8は論文のグラフィカルアブストラクトです。いずれもこのライセンスにもとづいて使っています。