04 — 論文 / やさしい解説
天候から見込める上限に、
実際の収量はなぜ届かないのか
フィリピンで約50年続く長期連作試験を、作物モデルと機械学習で読み解きました
田んぼでとれる米の量には、その季節の天候と品種で決まる上限があります。フィリピンには、同じ田んぼで1年に3回イネを作り続けてきた長期連作試験があります。私たちはその約50年分の記録を使い、上限と実際の収量の差を調べました。雨季の収量は上限の半分ほどで、その差を広げていた大きな要因は、病気と品種の古さでした。計算上この2つを除いても、収量は上限の63〜69%にとどまり、よく使われる目安の80%には届きませんでした。
この研究のポイント
- 窒素肥料を多く与えた区でも、乾季の収量は上限の約65%でした。雨季前半は約52%、雨季後半は約47%と、半分ほどにとどまりました。
- 季節を通して最も影響が大きかったのは、窒素肥料の量でした。そのほか、乾季はウイルス病のツングロ病が、雨季後半は品種の古さが、差を広げていました。
- 病気と品種の古さを除いて計算しても、収量は上限の63〜69%でした。熱帯の雨季では、80%という世界の目安に届くのは難しいと考えられます。
同じ田んぼで、あとどれだけとれるのか
同じ田んぼから、あとどれだけ多くの米がとれるのか。食料を安定して確保する方策を考えるうえで、出発点になる問いです。
イネの収量には上限があります。水と養分が十分にあり、病気や害虫の被害もないときにとれる量で、これを「潜在収量」と呼びます。その季節の日射や気温と、品種の性質で決まる値です。
実際の収量は、潜在収量より少なくなります。この差が「収量ギャップ」です。この研究では、実際の収量が潜在収量の何%にあたるかを「相対収量」として表しました(図1)。相対収量が高いほど、差は小さいことになります。差の大きさと原因がわかれば、効果の大きい対策から手をつけられます。
ただし、実際の田んぼで上限の100%をとることは、現実的ではありません。病害虫を完全には防げず、天候の変動や管理の限界もあるためです。そこで世界では、上限の約80%が、よく管理された田んぼの目安として広く使われてきました。
収量ギャップの分析は、これまで主に農家の田んぼで行われてきました。一方、同じ田んぼで何十年も続く長期試験は、条件をそろえた記録が積み重なっており、収量が変わった理由を探すのに向いています。しかし、長期試験の記録で収量ギャップを分析した例は、ほとんどありませんでした。
50年分の記録を、4つの手順で読み解く
同じ田んぼで、1年に3回イネを作る試験
舞台は、フィリピンのロスバニョスにある国際稲研究所(IRRI)の長期連作試験です。水を引いて育てる田んぼ(灌漑水田)で1年に3回イネを作る試験として、世界で最も長く続いています。
作付けは、乾季(1〜4月)、雨季前半(5〜8月)、雨季後半(9〜12月)の年3回です。作付けの間の休みは、1〜3週間しかありません。田んぼは窒素肥料の量で4つの区に分かれています。窒素肥料を与えない区がF1、量を3段階に増やした区がF2〜F4です。
品種は、病気や害虫に強い新しいものへ定期的に入れ替えられ、1968〜2017年に72品種が使われました(図2)。分析には、1971〜2017年の記録を使いました。それより前の気象データは、変動が不規則だったためです。
分析は、図3の4つの手順で進めました。
作物モデルで、上限を計算する
潜在収量は、ORYZA(オリザ)という作物モデルで計算しました。作物モデルは、日々の日射や気温などから、イネの育ち方と収量を計算するプログラムです。計算では、水も養分も十分で、病気や害虫の被害もないと仮定しました。
計算に使った品種は、この試験で10年以上使われたIR8、IR72、IRRI 146の3つです。3品種の計算値の平均を、各年・各季節の潜在収量としました。気象には、気象庁が過去の天気を途切れなく再現したデータ(JRA-55)を使い、現地の観測値に合わせて補正しました。
相対収量で、差の大きさを測る
実際の収量を潜在収量で割り、相対収量を求めました。主に見たのは、窒素の多いF3とF4の2区の平均です。毎年いちばんよくとれた品種と肥料の組み合わせについても、同じように計算しました。
機械学習で、差の原因を探す
次に、相対収量が年によって上下する原因を、機械学習で探しました。機械学習は、たくさんの記録から、コンピューターに規則性を学ばせる方法です。ここではランダムフォレストという手法で、季節ごとにモデルを作りました。
手がかりには、窒素肥料の量、病気の起こりやすさ、品種、品種の古さ、作付けの回数などを使いました。品種の古さは、その品種が試験に入ってから何年たったかを表します。各要因の効き方は、SHAP(シャップ)という方法で数値にしました。モデルの正確さは、1年分ずつデータを伏せて予測し、答え合わせをして確かめました。
病気の程度は、50年分そろった記録がありません。そこで、天気から病気の広がりやすさを計算するモデル(EPIRICE)を使いました。対象は、葉いもち、ごま葉枯病、白葉枯病、紋枯病、ツングロ病の5つです。指標は実際の被害ではなく、天気から見積もった「起こりやすさ」です。
「もしも」の計算
最後に、私たちが以前の研究(2025年)で作った、収量を予測する機械学習のモデルを使いました。予測したのは、病気の指標を0にした場合、品種の古さを0にした場合(どの品種も試験に入れたばかりの状態)、その両方の場合です。予測した収量を、潜在収量と比べました。両方を0にした計算は、ORYZAが想定する「ストレスのない条件」に近いものです。
季節によって、差の大きさも原因も違った
雨季は、上限の半分ほどしかとれていなかった
潜在収量は乾季が最も高く、1 haあたり平均10.41 tでした(10 aあたり1,041 kg)。雨季前半は8.63 t、雨季後半は7.15 tです。
窒素の多いF3とF4の実際の収量は、乾季で6.52〜6.86 tでした。雨季前半は4.39〜4.50 t、雨季後半は3.28〜3.38 tです(図4)。相対収量にすると、乾季64.5%、雨季前半51.7%、雨季後半46.7%で、雨季は上限の半分ほどでした。
毎年いちばんよくとれた品種と肥料の組み合わせでも、傾向は同じでした。相対収量は乾季72.6%、雨季前半60.4%、雨季後半56.0%です。80%に届いた年は、乾季でも全体の23.4%にとどまります。雨季では、雨季前半の数年を除いて、一度も届いていません。
潜在収量は、年による変動が小さいことも特徴です。差の大きさを年ごとに左右していたのは、主に実際の収量のほうでした。
また、相対収量は1990年代の初めを境に、8.0〜15.0ポイント高くなっていました。この時期の栽培管理の改善で、一段上がったと考えられます。
差を生む要因は、季節ごとに違った
機械学習で調べると、季節を通して最も影響が大きかったのは、窒素肥料の量でした(図5)。窒素が収量を左右することは各地の農家の田んぼでも示されており、予想どおりの結果です。そのうえで、季節ごとに異なる要因が見えてきました。
乾季では、ツングロ病が差を広げていました。ツマグロヨコバイの仲間がうつすウイルス病で、この試験では、作付けの時期がずれたまわりの田んぼから広がっていました。はっきりした症状がないまま、実る籾(もみ)を減らすことがあります。窒素が多いほど、ツングロ病による減収が大きくなる傾向も見られました。窒素で葉が茂ると、ヨコバイがすみやすくなるという報告と合う結果です。
雨季前半では、試験が始まってからの作付けの回数が多いほど、差が小さくなっていました。
雨季後半では、品種の古さが差を広げていました。その重要さは、窒素肥料に次ぐものでした。同じ品種を長く使ううちに病原体や害虫も変わり、品種の抵抗性が効きにくくなることが、これまでの研究で示されています。
病気と品種の古さを除くと、雨季の差が縮んだ
すべての要因を入れて予測すると、相対収量は乾季65.1%、雨季前半51.5%、雨季後半45.1%でした(図6)。窒素の多い区で実際に見られた値に近い数字です。病気と品種の古さを除くと、乾季69.0%、雨季前半63.4%、雨季後半69.4%に上がりました。特に雨季で、大きく改善しています。
雨季では、この2つを除いた予測が、ORYZAの上限と年ごとによく連動するようになりました。雨季の差の主な原因は、ORYZAの計算に含まれていない病気と品種の入れ替わりだったといえます。それでも、どの季節も80%には届きませんでした。
乾季に残った、計算のずれ
乾季では、この2つを除いても、予測とORYZAの上限は連動しませんでした。上限と予測の差が特に大きかった年(4.1 t/ha以上)は7年あり、すべて乾季でした。
これらの年は、穂ができる時期の最高気温が平均32.3 °Cで、ほかの年(30.4 °C)より高めでした。日射も強く、ツングロ病も起こりやすい条件でした(図7)。ORYZAでは、高温が光合成に与える影響を十分に表せていない可能性があります。ただし、モデルの限界か、入力データの誤差か、別の要因かは、この研究では判断できません。
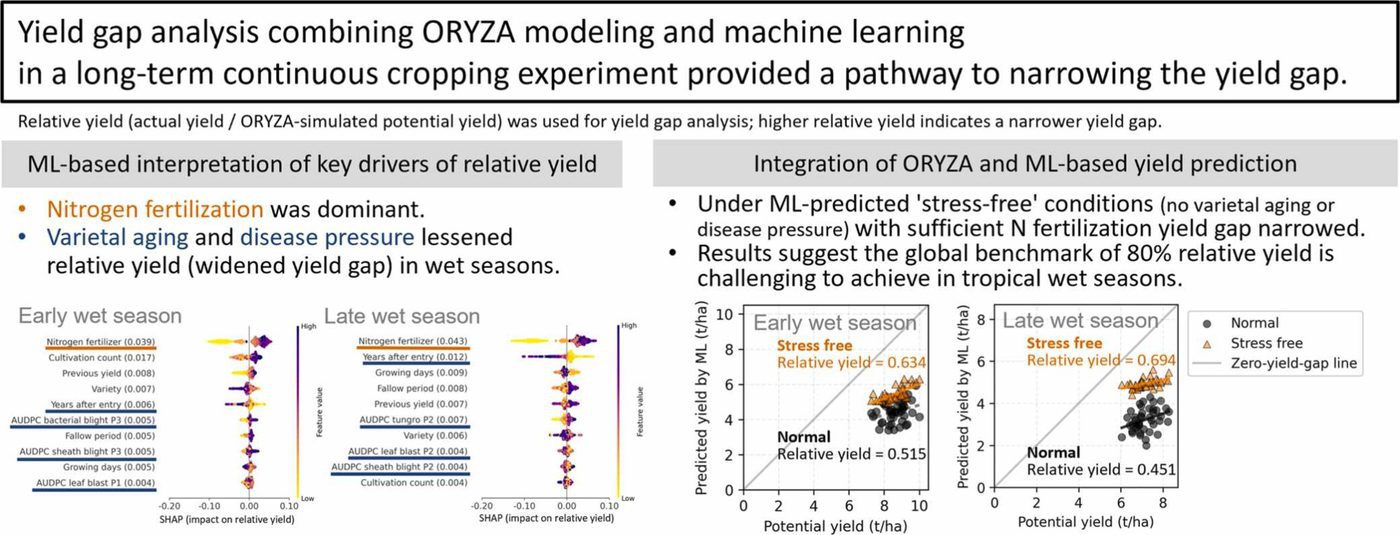
季節に合った目安と、差を縮める手がかり
世界では、上限の80%が、よく管理された田んぼの目安とされてきました。しかし、この試験の雨季では、病気と品種の古さを除いた計算でも63〜69%でした。熱帯の湿潤な条件、特に雨季では、上限の約70%を安定して超えることさえ難しいのかもしれません。
乾季では、1990年代に管理が見直されたあと、平均で上限の77%まで近づいていました。一律の80%ではなく、季節や土地の条件に合った目安が必要だと、私たちは考えています。
差を縮める手がかり
雨季では、品種をこれまでより頻繁に新しいものへ替えることと、病気の対策を強めることが役立つと考えられます。
乾季では、ツングロ病の対策が鍵です。効果が知られているのは、抵抗性のある品種を使うことや、まわりの田んぼと田植えの時期をそろえることです。作付けの間に田んぼを休ませる期間(休閑期間)をとって、ウイルスの源を減らす方法もあります。窒素の与え方を病気の対策と合わせて見直せば、差をもう少し縮められる可能性もあります。
毎年いちばんよくとれた品種と肥料の組み合わせは、窒素の多い区の平均を、相対収量で6.5〜10.0ポイント上回りました。品種の選び方は、肥料の管理と並んで、差を縮める手立てになります。
作物モデルは天候が許す上限を、機械学習は実際の田んぼで差を生む要因を示します。この2つを組み合わせることで、差の大きさと原因を、季節ごとに診断できました。
まだわかっていないこと
- この結果は、熱帯の灌漑した田んぼで行われた、1つの長期連作試験から得たものです。
- 病気の指標は天気から計算した起こりやすさで、実際の被害を測ったものではありません。
- ORYZAの上限は、病気や品種の古さ、窒素の不足を扱っていません。雨季前半の結果については、季節の初めの気温上昇で土の窒素が増えた可能性が、以前の研究で指摘されています。
- 乾季のずれの原因と、残る差をどこまで縮められるかは、これから確かめる必要があります。
これから
私たちは、次のような組み合わせが有効だと考えています。ORYZAで季節ごとの上限を示し、そこに生育の時期ごとの病気のリスクと品種の入れ替わりを組み込みます。そのうえで、残る差を機械学習で見積もります。乾季については、穂ができる時期の高温や日射への反応など、さらに調べるべき点があります。
用語の解説
- 潜在収量
- 水と養分が十分で、病気や害虫の被害もないときにとれる収量の上限です。その季節の天候と、品種の性質で決まります。
- 収量ギャップ
- 潜在収量と、実際の収量との差です。
- 相対収量
- 実際の収量が、潜在収量の何%にあたるかを示す値です。高いほど、収量ギャップは小さくなります。
- 作物モデル(ORYZA)
- 日々の天気などから、作物の育ち方と収量を計算するプログラムです。ORYZAはイネのためのモデルです。
- 機械学習(ランダムフォレスト)
- データから、コンピューターに規則性を学ばせる方法です。ランダムフォレストは、「はい・いいえ」で枝分かれする予測をたくさん作り、その答えを平均します。
- SHAP(シャップ)
- 予測に、それぞれの要因がどれだけ、どちら向きに効いたかを数値で示す方法です。
- 品種の古さ
- その品種が試験に入ってからの年数です。長く使ううちに、病気や害虫への強さが落ちることがあります。
- ツングロ病
- ツマグロヨコバイの仲間がうつす、イネのウイルス病です。はっきりした症状がないまま、収量を下げることがあります。
- EPIRICE
- 天気から、イネの病気の広がりやすさを計算するモデルです。この研究では、5つの病気について、生育の時期ごとに指標を求めました。
論文の情報
Tomoaki Yamaguchi, Ando Mariot Radanielson, Olivyn Angeles, Keisuke Katsura & Kazuki Saito (2026). Understanding rice yield gaps with crop modeling and machine learning in a long-term continuous cropping experiment. Field Crops Research, 342, 110477. https://doi.org/10.1016/j.fcr.2026.110477
この論文はオープンアクセスで、誰でも無料で読めます。ライセンスはCC BY 4.0です。図8は論文から転載し、図4・図6・図7は論文の数値をもとに作成しました。