04 — 論文 / やさしい解説
AIに農家さん向けの助言を書き直させると、
3〜4回目までは良くなる
説明可能なAIの結果を、AIが農家さん向けの助言に書き直しました。その11回分を、作物学の研究者とAIが採点しました
機械学習でイネの収量の決め手を調べても、その結果を農家さんにわかる言葉で伝えるのは簡単ではありません。私たちは、大規模言語モデル(LLM)に分析を足させながら、農家さん向けの助言を10回書き直させました。作物学の研究者12人が採点すると、助言の質は3回目に最も高くなり、そのあと下がって、10回目には最初より低くなりました。AIに書き直しを任せるときは、ちょうどよいところで止めることが大切です。
この研究のポイント
- 書き直しを重ねると、助言の点数は最初より3割ほど上がりました。最も高かったのは3〜4回目で、そのあとは下がり、専門家の採点では10回目が最初を下回りました。
- 早い回の助言はあいまいで、回を重ねすぎると長く抽象的になりました。データに経済の情報がないのに、費用の話がふくらんでいきました。
- LLMによる採点は、専門家より1.4〜2.3点甘くなりました。それでも、どの回がよいかの順番は、おおむね一致しました。ただし、助言を書いたのと同じAIは、採点役として最も外れていました。
AIの分析を、現場の言葉にする
機械学習を使うと、収量のデータから、収量を左右する要因を探せます。AIがなぜその予測をしたのかを、人が理解できる形で示す技術を、説明可能なAI(XAI)と呼びます。よく使われるSHAP(シャップ)という方法では、どの要因が、どちら向きに、どれだけ収量に効いたかを図にできます。
ただ、この図は研究者向けです。農家さんがそのまま読んで、明日の作業に生かせるものではありません。分析の結果が伝わらなければ、AIの予測は信頼されず、現場で使われることもありません。
そこで期待されているのが、ChatGPTのような大規模言語モデル(LLM)です。LLMは、専門的な説明をふだんの言葉に置き換えるのが得意です。最近は、自分で考え、必要な分析を足し、答えを見直しながら作業を進める「AIエージェント」としての使い方も広がっています。
では、AIエージェントに説明を何度も書き直させれば、助言はどこまでもよくなるのでしょうか。私たちは、そうではないと考えました。説明が短すぎると、大事なことが抜け落ちます。長すぎると、要点が埋もれてしまいます。ちょうどよい詳しさが、どこかにあるはずです。
この研究では、AIエージェントに助言をくり返し書き直させ、その質が回ごとにどう変わるかを調べました。採点は、作物学の研究者とLLMの両方にお願いしました。
AIに、助言を10回書き直させる
福島県の28枚の田んぼのデータ
使ったのは、福島県富岡町で1つの経営体が作っている、28枚の田んぼ(合わせて約7.5 ha)のデータです。2021〜2023年に4つの品種を作り、田んぼと年の組み合わせで66件の記録があります。
手がかりにしたのは37の項目です。土の性質が7つ(有機物や窒素の量など)、天気が20項目(生育の4つの時期ごとの気温・雨・日射)です。栽培の管理は10の項目で、品種、穂が出るまでの日数、種を直接まくか苗を植えるか、有機栽培かどうかなどです。収量には、ドローンの画像からAIで推定した値を使いました(別の解説で紹介しています)。
収量の予測には、機械学習のランダムフォレストを使いました。1件ずつ伏せて予測し、答え合わせをして確かめると、予測の当たり具合を示す決定係数(R²、1に近いほどよい)は0.749でした。この予測にSHAPを当てはめ、収量に効いた上位20の要因を1枚の図にまとめました。この図が、AIエージェントに渡す出発点です。
3つの手順をくり返す
助言を書くAIには、AnthropicのClaude Sonnet 4を使いました。0回目は、SHAPの図と37の項目の一覧だけを見せて、農家さん向けの助言を書かせました(図1)。
1〜10回目は、毎回3つの手順をくり返しました。まず、AIが自分の助言を見直し、確かめたい点を探して、そのための分析をPythonのコードで書きます。次に、人がそのコードを田んぼのデータで動かし、結果の表や図をPDFにまとめます。最後に、AIがそのPDFとSHAPの図をもとに、助言を書き直します。それまでのやりとりはすべて残したので、回を重ねるほど、AIが使える分析の結果が積み重なっていきます。
回の順番を伏せて、専門家とAIが採点する
できあがった11回分の助言は、2つのグループが採点しました。1つは、作物学の研究者12人です。全員が博士号を持つ、日本作物学会の会員(元会員を含む)です。もう1つは、OpenAI、Anthropic、xAI、DeepSeek、Googleの5社の、LLM 14種類です。LLMに採点させる方法は「LLM-as-a-judge」と呼ばれ、人に頼むよりも手軽に、たくさんの評価ができます。
採点の観点は、次の7つです。
- 具体性は、数値や手順など、そのまま参考にできる情報があるかです。
- わかりやすさは、理解しやすく、筋道がはっきりしているかです。
- 簡潔さは、忙しい農家さんが、作業の合間にすぐ読めるかです。
- 実行しやすさは、ふつうの農家の人手や技術、時間で実行できるかです。
- 現場との合致は、データの地域や品種、規模、管理に合っているかです。
- 費用への配慮は、費用や、かけたお金に見合う効果を考えているかです。
- 作物学としての確かさは、作物学の知見から見て正しいかです。
どれも、1点(とても悪い)から7点(とてもよい)で採点しました。助言を見せる順番は採点者ごとにばらばらにし、何回目の助言かは伏せました。LLMには、過去の会話の影響が残らない新しい画面で採点させました。
よくなるのは、3〜4回目まで
3〜4回目に山があり、そのあと下がった
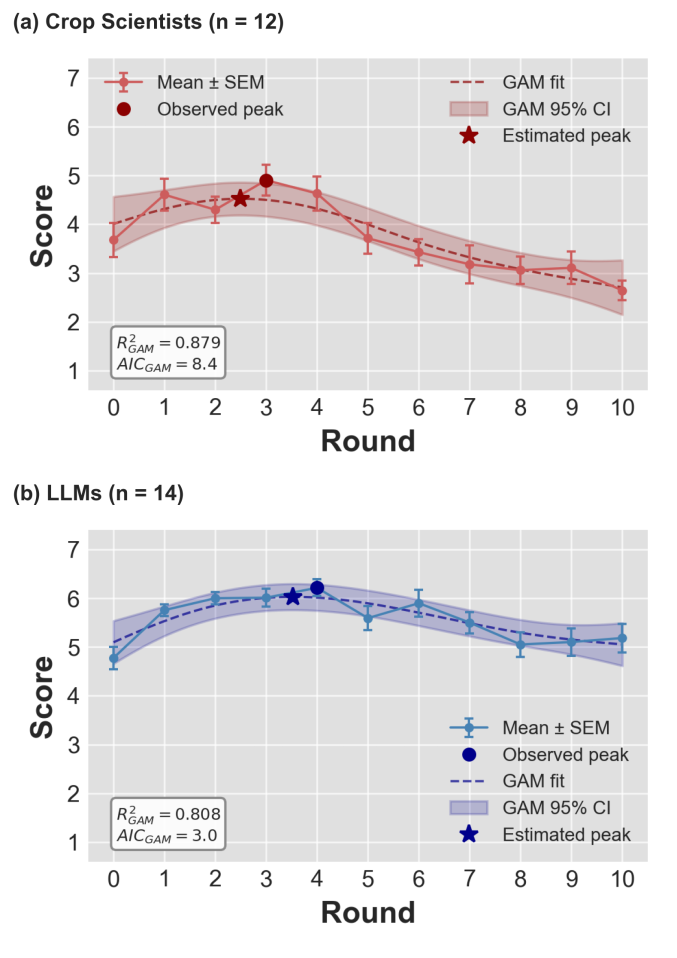
7つの観点の平均点は、どちらのグループでも山なりに動きました(図2)。作物学の研究者の採点では、0回目の3.68点から3回目の4.91点まで上がり、10回目には2.64点まで下がりました。10回目は、書き直す前の0回目よりも低い点です。
LLMの採点では、0回目の4.78点から4回目の6.21点まで上がり、10回目は5.18点でした。最初からの伸びは、どちらも3割ほど(30〜33%)です。
あいまいな言葉が、数値に変わった
点が上がった理由は、助言の中身を見るとわかります。図3は、生育初期の温度の管理について、0回目と3回目の助言を並べたものです。
0回目も、品種の選び方や水の深さなど、手を打つべき点は挙げていました。しかし、「適切な」「浅く」のように、どうすればよいかがはっきりしない言葉が残っていました。3回目には、同じ点が、確かめられる数値と、そのときの対策に変わりました。たとえば「田植えから40日間」「水深3〜5 cm」「最高気温が22 °Cを下回る日が5日より長く続いたら」です。専門家の採点で最も大きく伸びた観点も具体性で、2.17点上がりました。
なお、図3の助言はAIが書いたものをそのまま訳したもので、内容の正しさを私たちが保証するものではありません。
回を重ねると、分析がふくらみ続けた
AIが行う分析は、回を追うごとに増えていきました(図4)。統計の手法や図の種類は、ほぼ毎回新しいものが加わり、作った図の数は、0回目の1枚から、10回目には合わせて93枚になりました。
分析の向きも変わりました。0〜3回目は、収量が決まるしくみや、管理と天気の関係を調べていました。4〜8回目には、投資に見合うかどうかの試算や、田んぼのタイプ分け、長い目で見た持続性へと広がりました。9〜10回目には、分析を複雑にしたことが本当に農家さんの役に立つのかを、AI自身が疑い始め、注意点をまとめる方向へ進みました。
観点ごとに、違う動きをした
7つの観点を1つずつ見ると、動きは3つの型に分かれました(図5)。山なりになったのは、具体性、わかりやすさ、実行しやすさ、現場との合致、作物学としての確かさの5つです。どれも2〜4回目に山があり、そのあと下がりました。ただし、LLMの採点では、わかりやすさだけは高いまま変わりませんでした。簡潔さは、早い回から下がり続けました。助言が長くなっていったためです。
費用への配慮だけは、回を重ねるほど上がりました。しかし、このデータには、費用や米の値段といった経済の情報がひとつも入っていません。AIは、データにもとづかない経済の話を、もっともらしくふくらませていたことになります。
早い回の助言は、具体性が足りませんでした。回を重ねすぎると、長く、抽象的で、根拠のない話が増えました。説明が足りない状態と、詳しすぎる状態の間に、ちょうどよいところがあったといえます。機械学習でいう「バイアスとバリアンスのトレードオフ」に似た関係です。
LLMの採点は甘いが、順番はおおむね合っていた
LLMの採点は、7つの観点のすべてで、専門家より1.4〜2.3点高くなりました(図6)。7点満点で見ると、大きな差です。LLMがつけた点数を、そのまま専門家の評価の代わりにはできません。
一方で、どの回がよく、どの回が悪いかという順番は、おおむね一致していました。順番がどれだけそろっているかを示す値(スピアマンの順位相関係数ρ、1に近いほど一致)は、0.58〜0.90でした。最も点の高かった回も、7つの観点と平均のすべてで、両者の差は1回以内でした。
ただし、LLMを1つずつ見ると、違いは大きくなりました。専門家が最もよいとした回を、最もよく当てたのはGemini 3.0 Proです。8つの点数(7つの観点と平均)のうち7つで、ずれが1回以内に収まりました。最も外れたのはClaude Sonnet 4で、収まったのは1つだけでした。Claude Sonnet 4は、助言を書いたのと同じAIです。自分の書いたものを自分で採点させるのは、避けたほうがよいと考えられます。
止めどきを決め、途中の記録を残す
AIに書き直しを任せても、助言はどこまでもよくなるわけではありませんでした。よくなるのは最初の数回で、それを過ぎると、長く、抽象的で、根拠のない内容が増えていきます。AIエージェントに説明を書き直させるときは、どこで止めるかを、はじめからしくみに組み込む必要があります。
止めどきを、誰が決めるか
専門家が毎回すべての助言を採点するのは、手間がかかりすぎます。LLMの採点は、点数こそ甘いものの、よい回の順番はおおむね追えていました。止めどきを知らせる役なら、LLMに任せられる可能性があります。
そのための手順として、私たちは次の形を提案しています。はじめに一度だけ、専門家に小さな試験の採点をしてもらいます。その結果と照らして、専門家とよく合うLLMだけを採点役に選びます。このとき、助言を書くAIと同じ系統のモデルは外します。本番では、選んだ複数のLLMで回ごとに採点し、点が伸びなくなったところで止めます。最後に、選ばれた助言だけを専門家が確かめます。
途中の記録を、すべて公開する
AIが自分で書いたコードには、誤りが混じることがあります。回を重ねるほど、農家さんが信頼しなければならないものも増えていきます。元の予測モデル、SHAPの図、AIが書いたコードと分析、そしてそれらをまとめた助言です。
この研究では、AIへの指示文と、各回でAIが書いたコード、作った図、助言のすべてを、研究データの公開サイトZenodo(ゼノド)で公開しました(https://doi.org/10.5281/zenodo.17876329)。途中の過程を誰でも確かめられることが、AIエージェントの助言を信頼するための前提になると、私たちは考えています。
まだわかっていないこと
- この論文はプレプリント(査読前の原稿)で、まだ専門誌の審査を経ていません。
- 結果は、福島県の1つの経営体の田んぼのデータから得たものです。ほかの作物や地域で同じ傾向になるかは、確かめていません。
- 助言を書いたAIは、Claude Sonnet 4の1つだけです。採点したLLMも、同じ会社のモデルどうしで、似た癖を持っている可能性があります。
- 助言の質は、書かれた時点で採点したものです。農家さんが実際に使ってどうなったかは、まだ調べていません。
これから
最も大切なのは、農家さん自身による評価です。助言がわかりやすく、実際に役立つかを判断するのは、使う人だからです。また、点が伸びなくなったところで、新しいデータや文献をAIに渡せば、もう一段よくできるかもしれません。こうしたしくみを、ほかの作物や分野でも確かめていきます。
用語の解説
- 説明可能なAI(XAI)
- AIがなぜその予測をしたのかを、人が理解できる形で示す技術です。
- SHAP(シャップ)
- 予測に、それぞれの要因がどれだけ、どちら向きに効いたかを数値で示す方法です。
- 大規模言語モデル(LLM)
- 大量の文章から学び、人のように文章を読み書きするAIです。ChatGPT、Claude、Geminiなどがあります。
- AIエージェント
- 目的に向けて、自分で考え、道具を使い、結果を見直しながら作業を進めるAIの使い方です。
- エージェント型XAI(Agentic XAI)
- この研究で提案した方法です。AIエージェントが、XAIの結果の説明をくり返し書き直し、よりよい説明を探します。
- 機械学習(ランダムフォレスト)
- データから、コンピューターに規則性を学ばせる方法です。ランダムフォレストは、「はい・いいえ」で枝分かれする予測をたくさん作り、その答えを平均します。
- LLM-as-a-judge
- LLMに、文章などの質を採点させる方法です。
- バイアスとバリアンスのトレードオフ
- 機械学習の考え方です。モデルが単純すぎると大事な傾向を取りこぼし(バイアス)、複雑すぎると偶然のばらつきまで拾ってしまいます(バリアンス)。この研究では、説明の詳しさにも同じような関係があると考えました。
- スピアマンの順位相関係数(ρ)
- 2つの順番が、どれだけそろっているかを示す値です。1なら、まったく同じ順番です。
論文の情報
Tomoaki Yamaguchi, Yutong Zhou, Masahiro Ryo & Keisuke Katsura (2025). Agentic Explainable Artificial Intelligence (Agentic XAI) Approach To Explore Better Explanation: A Case Study in Decision Support for Rice Cultivation in Japan. arXiv, 2512.21066. https://doi.org/10.48550/arXiv.2512.21066
この論文はプレプリント(査読前の原稿)で、arXivで誰でも無料で読めます。ライセンスはCC BY 4.0です。図2は論文から転載しました。図3は論文の図を訳して作成し、図4〜6は論文の数値をもとに作成しました。